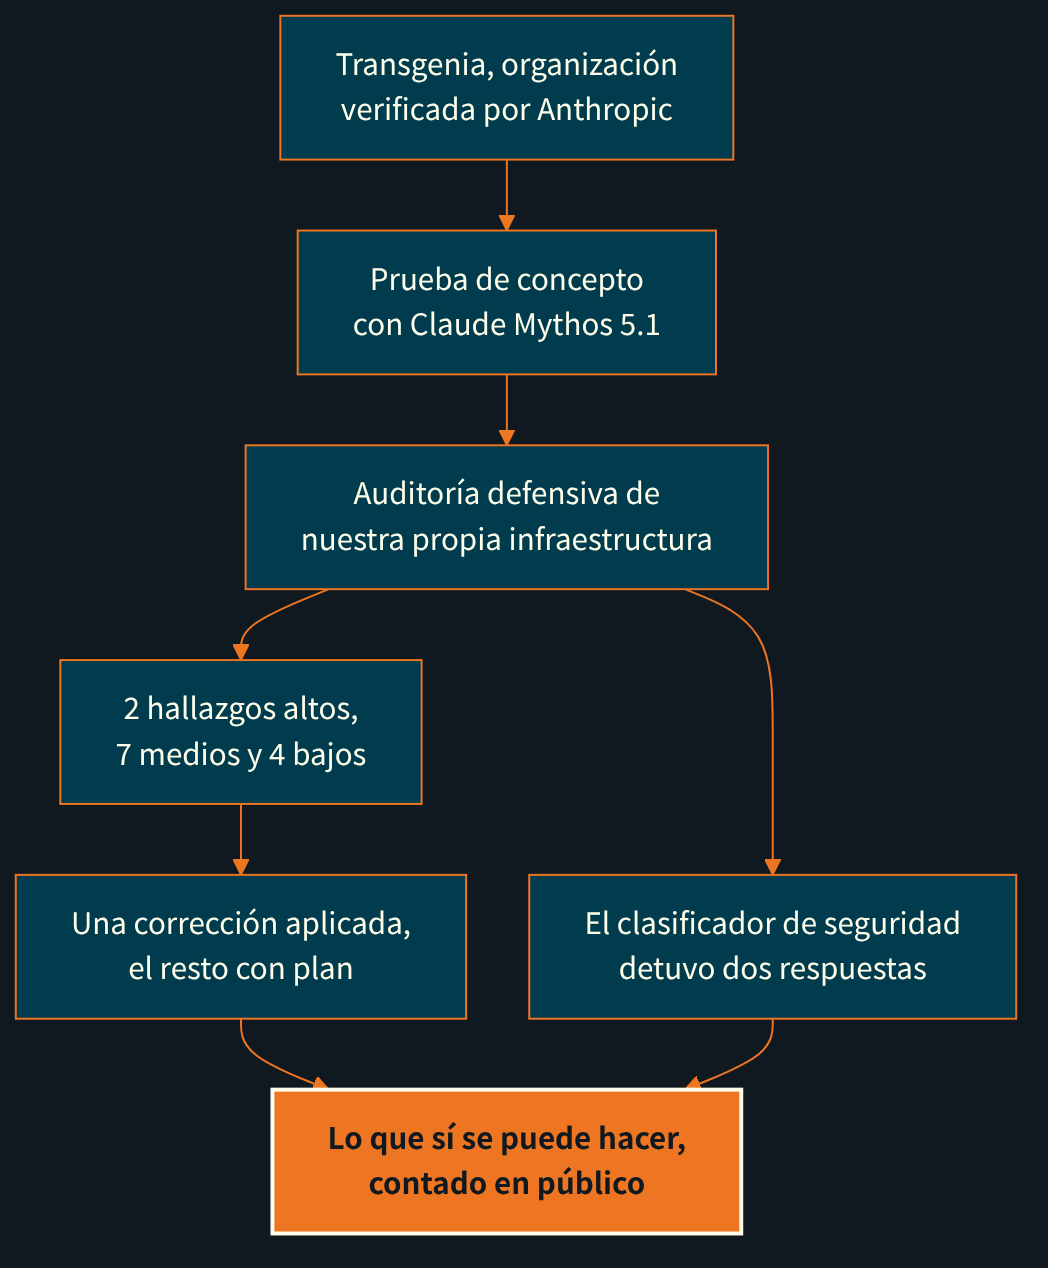
El 7 de noviembre de 2026, Anthropic aprobó a Transgenia para el Acceso de Defensa de su Cyber Verification Program. Dos días después pusimos a Claude Mythos 5.1, el modelo que Anthropic solo ofrece a organizaciones verificadas, a revisar nuestro propio servidor de producción. En 26 minutos teníamos un informe con 13 hallazgos y un plan de corrección. Después, en dos momentos, un clasificador de seguridad detuvo sus respuestas. Esta es la historia completa: qué hicimos, qué encontramos, dónde se detuvo el modelo y qué sí se puede hacer con él.
Meta-estructura Mermaid
flowchart TB
    A["Transgenia, organización<br/>verificada por Anthropic"] --> B["Prueba de concepto<br/>con Claude Mythos 5.1"]
    B --> C["Auditoría defensiva de<br/>nuestra propia infraestructura"]
    C --> D["2 hallazgos altos,<br/>7 medios y 4 bajos"]
    D --> E["Una corrección aplicada,<br/>el resto con plan"]
    C --> F["El clasificador de seguridad<br/>detuvo dos respuestas"]
    E --> G["Lo que sí se puede hacer,<br/>contado en público"]
    F --> G
    class G clave
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
¿Qué es Claude Mythos 5.1 y quién puede usarlo?
Según la documentación de Anthropic, Claude Mythos 5.1 es el mismo modelo que Claude Fable 5.1, disponible solo para organizaciones verificadas por los programas de verificación de Anthropic, como el Cyber Verification Program. Se publicó el 1 de septiembre de 2026 y trabaja con una ventana de contexto de un millón de tokens. Transgenia es una de esas organizaciones verificadas.
Las salvaguardas no son opcionales. Anthropic documenta que sus modelos incluyen clasificadores de seguridad que pueden declinar una solicitud, y que la categoría de ciberseguridad cubre lo que podría facilitar un daño, como el desarrollo de malware o de exploits. La misma documentación advierte que el trabajo benigno de ciberseguridad también puede activarla. Anthropic fija esas salvaguardas por modelo y por categoría, y su programa de verificación exige que cada prueba esté autorizada de antemano por quien tiene autoridad sobre los sistemas.
¿Qué significa que Transgenia sea una organización verificada?
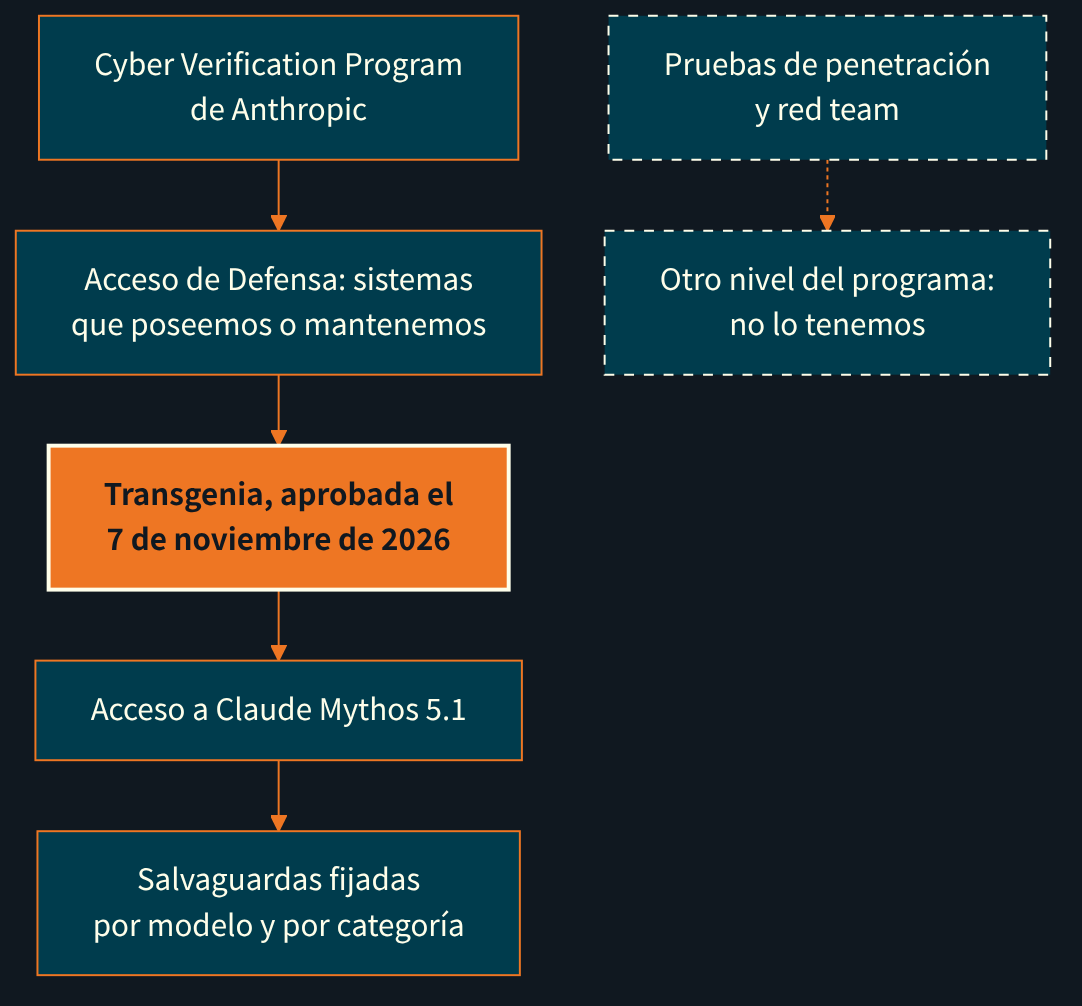
El 7 de noviembre de 2026, Anthropic notificó a Transgenia su aprobación para el Acceso de Defensa del Cyber Verification Program, con efecto inmediato. Según esa notificación, el Acceso de Defensa es para equipos que defienden sistemas que poseen o mantienen: triaje y verificación de vulnerabilidades, análisis de malware e ingeniería inversa, ingeniería de detección y respuesta a incidentes. Las pruebas de penetración autorizadas y el red team corresponden a otro nivel del programa, que hoy no tenemos.
Conviene decir también lo que no significa. No es una certificación ni un aval de Anthropic sobre nuestros servicios. Es una verificación que nos permite usar sus modelos más capaces, con sus salvaguardas, para defender. Esta auditoría fue nuestra primera prueba de concepto con ese acceso.
Meta-estructura Mermaid
flowchart TB
    A["Cyber Verification Program<br/>de Anthropic"] --> B["Acceso de Defensa: sistemas<br/>que poseemos o mantenemos"]
    B --> C["Transgenia, aprobada el<br/>7 de noviembre de 2026"]
    C --> D["Acceso a Claude Mythos 5.1"]
    D --> E["Salvaguardas fijadas<br/>por modelo y por categoría"]
    F["Pruebas de penetración<br/>y red team"] -.-> G["Otro nivel del programa:<br/>no lo tenemos"]
    class C clave
    class F,G fuera
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
    classDef fuera stroke:#FEFEEA,stroke-dasharray:5 5
¿Qué nos propusimos y qué dejamos fuera?
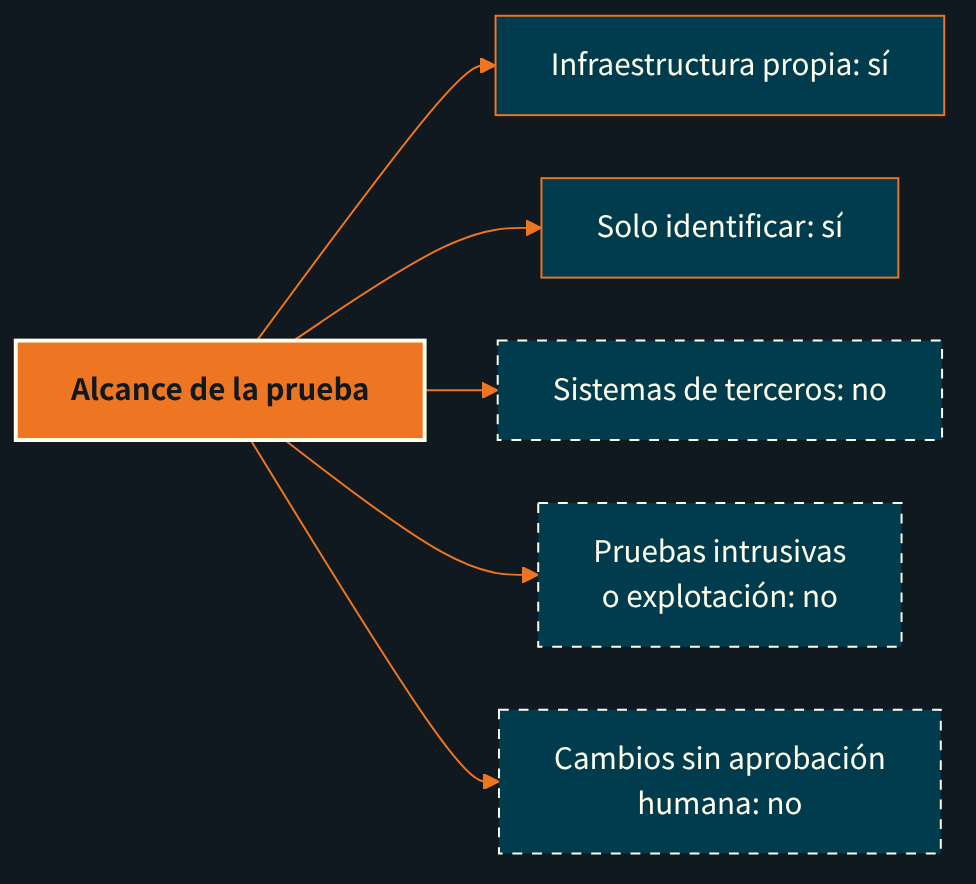
La pregunta fue concreta: ¿alguna aplicación nativa de nuestro servidor de producción, en particular en PHP y en Python, tiene una vulnerabilidad importante? El alcance quedó escrito antes de empezar. Solo infraestructura propia, solo identificación y ningún cambio sin aprobación de una persona. Quedaron fuera las pruebas intrusivas, la fuerza bruta, la explotación de vulnerabilidades y cualquier descarga de datos.
Meta-estructura Mermaid
flowchart LR
    A["Alcance de la prueba"] --> B["Infraestructura propia: sí"]
    A --> C["Solo identificar: sí"]
    A --> D["Sistemas de terceros: no"]
    A --> E["Pruebas intrusivas<br/>o explotación: no"]
    A --> F["Cambios sin aprobación<br/>humana: no"]
    class A clave
    class D,E,F fuera
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
    classDef fuera stroke:#FEFEEA,stroke-dasharray:5 5
¿Cómo trabajamos?
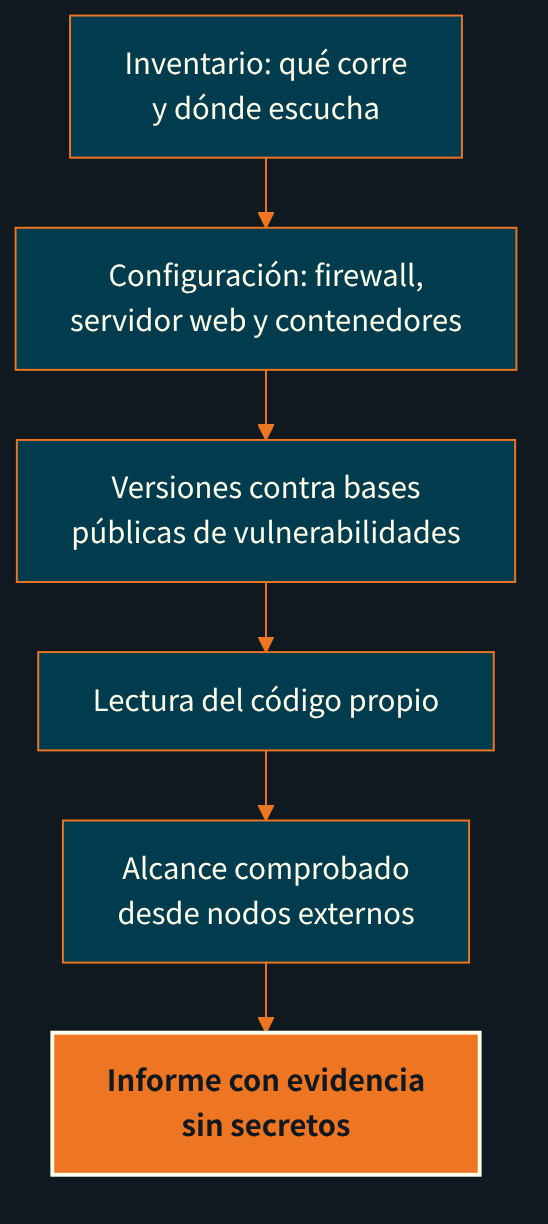
Identificar antes de tocar. El modelo trabajó en Claude Code con acceso de lectura al servidor y siguió seis pasos. Para cotejar versiones usó dos fuentes públicas: los avisos de seguridad de Packagist para las dependencias de PHP y la base OSV para las de Python. La evidencia quedó guardada sin contraseñas ni argumentos de procesos. Donde un archivo de configuración contenía secretos, se registró que existían, no su valor.
Meta-estructura Mermaid
flowchart TB
    A["Inventario: qué corre<br/>y dónde escucha"] --> B["Configuración: firewall,<br/>servidor web y contenedores"]
    B --> C["Versiones contra bases<br/>públicas de vulnerabilidades"]
    C --> D["Lectura del código propio"]
    D --> E["Alcance comprobado<br/>desde nodos externos"]
    E --> F["Informe con evidencia<br/>sin secretos"]
    class F clave
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
La revisión cubrió las aplicaciones en PHP, los servicios en Python, los contenedores y la capa de red con su firewall. Cada hallazgo quedó clasificado por severidad y con la evidencia que lo sostiene.
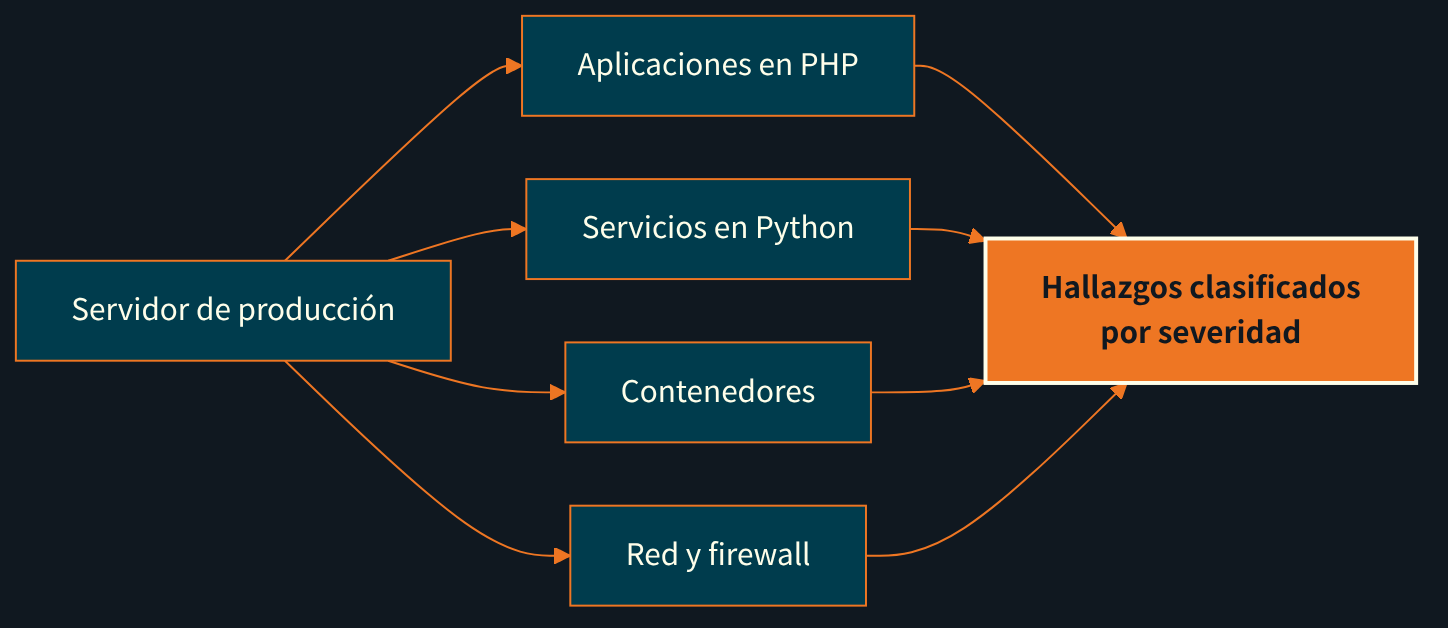
Meta-estructura Mermaid
flowchart LR
    S["Servidor de producción"] --> P["Aplicaciones en PHP"]
    S --> Y["Servicios en Python"]
    S --> C["Contenedores"]
    S --> R["Red y firewall"]
    P --> X["Hallazgos clasificados<br/>por severidad"]
    Y --> X
    C --> X
    R --> X
    class X clave
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
¿Qué encontramos?
Trece hallazgos: 2 de severidad alta, 7 de severidad media y 4 de severidad baja.
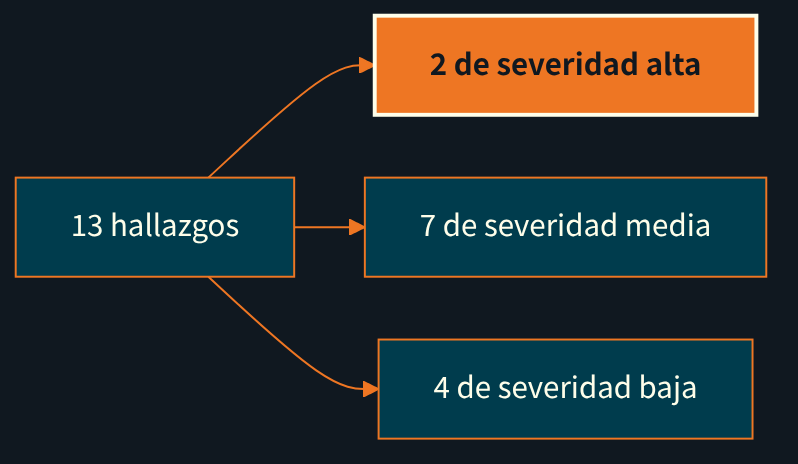
Meta-estructura Mermaid
flowchart LR
    A["13 hallazgos"] --> H["2 de severidad alta"]
    A --> M["7 de severidad media"]
    A --> L["4 de severidad baja"]
    class H clave
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
No publicamos el detalle de los hallazgos que siguen abiertos. Describir con precisión una debilidad sin corregir es entregársela a quien la busque. Sí podemos compartir los patrones que conviene buscar en cualquier servidor, porque en el nuestro aparecieron variantes de ellos.
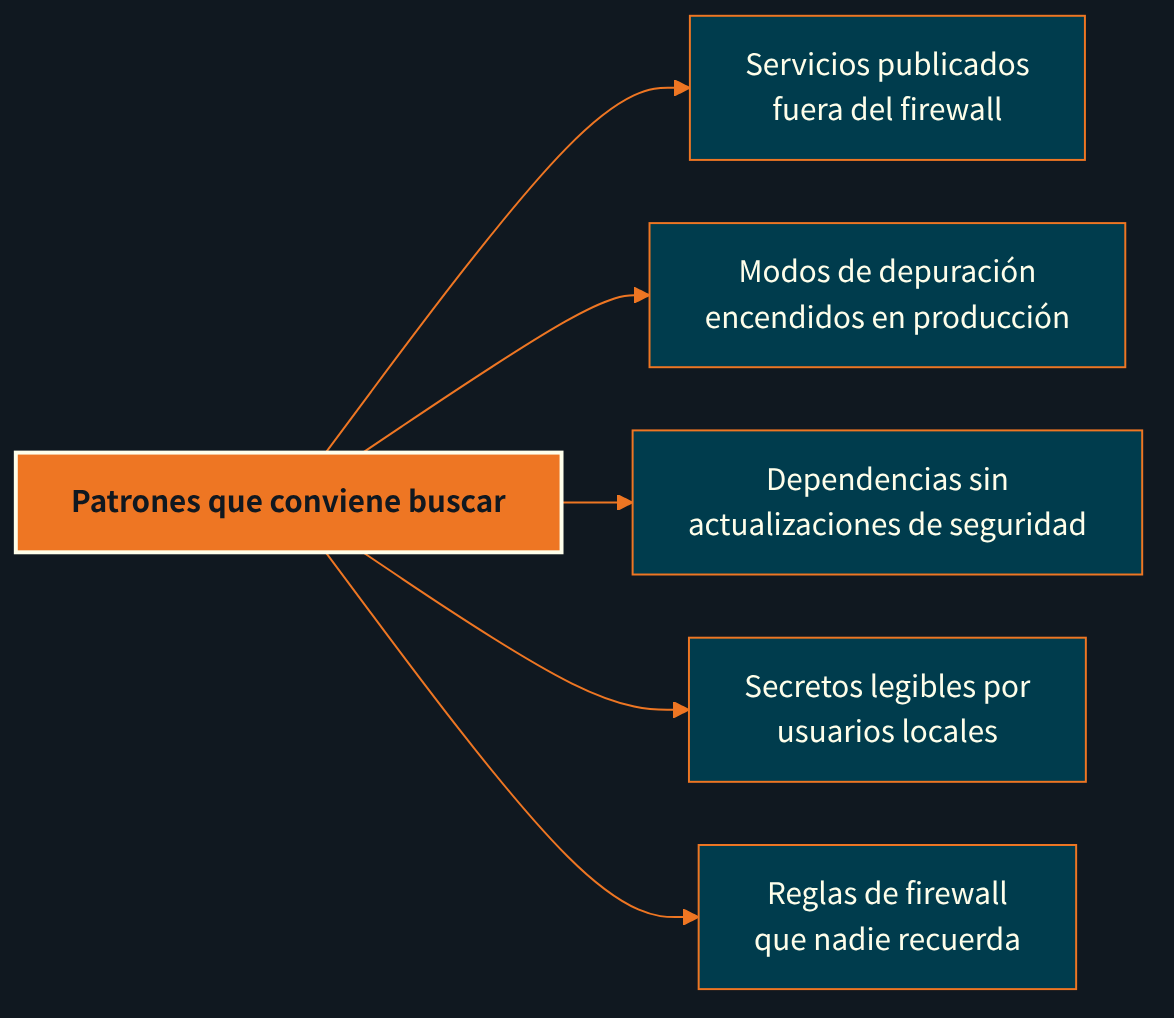
Meta-estructura Mermaid
flowchart LR
    A["Patrones que conviene buscar"] --> B["Servicios publicados<br/>fuera del firewall"]
    A --> C["Modos de depuración<br/>encendidos en producción"]
    A --> D["Dependencias sin<br/>actualizaciones de seguridad"]
    A --> E["Secretos legibles por<br/>usuarios locales"]
    A --> F["Reglas de firewall<br/>que nadie recuerda"]
    class A clave
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
Un informe útil también dice qué no hay que tocar. El modelo dejó constancia de lo que estaba bien hecho: el código propio de los formularios del sitio, la configuración endurecida de PHP, el acceso por SSH solo con llaves y las reglas que niegan el acceso a archivos sensibles.
¿Cómo pasamos de la detección a la corrección?
Con una regla simple: ningún cambio sin aprobación, respaldo y verificación. Una persona del equipo revisó el informe y aprobó dos correcciones.
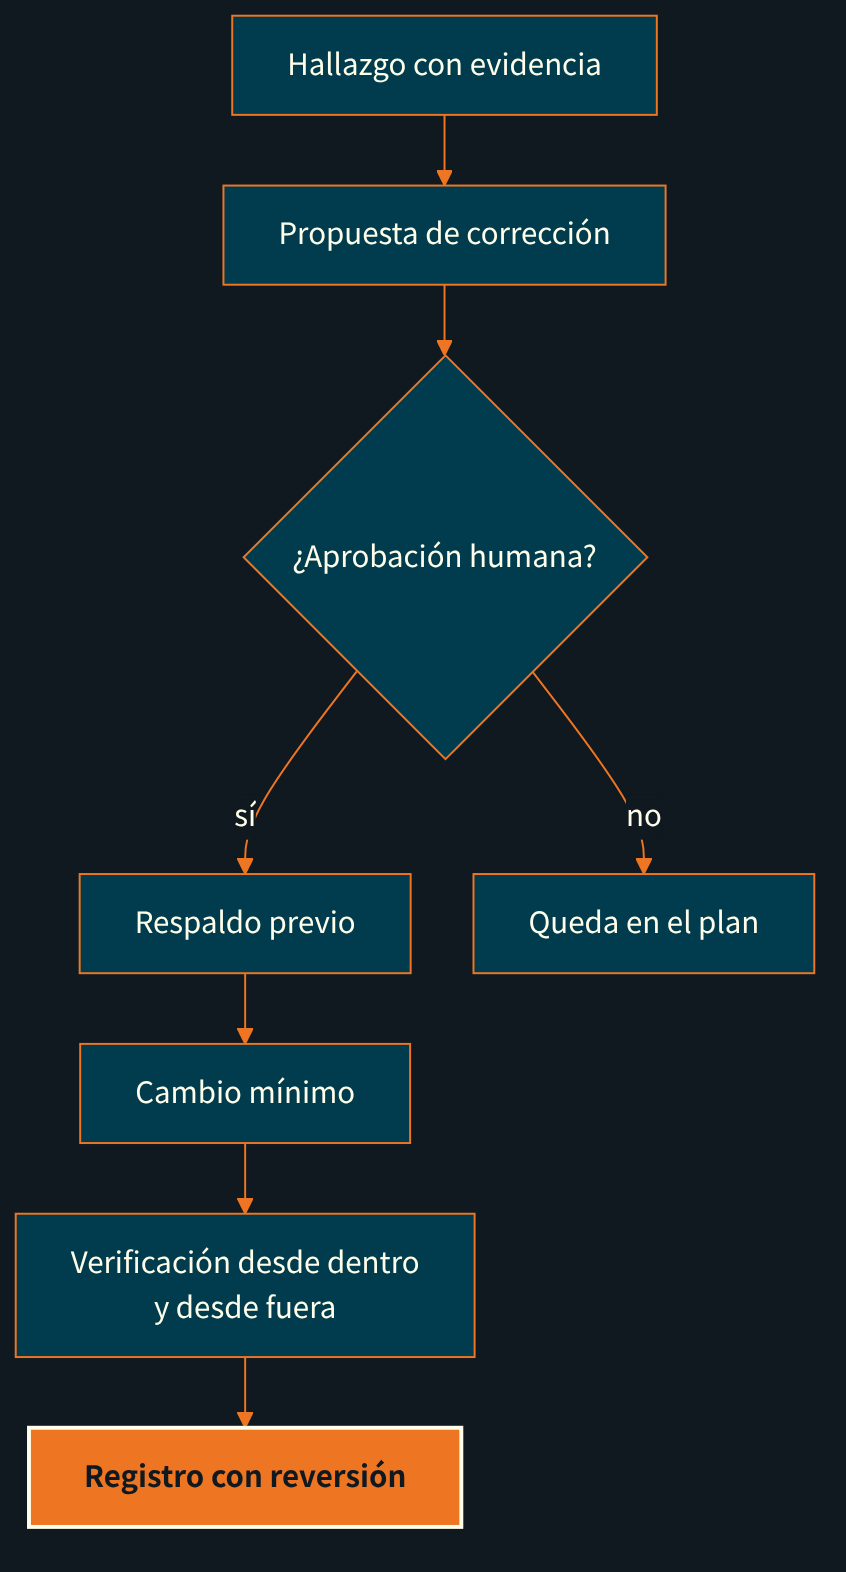
Meta-estructura Mermaid
flowchart TB
    A["Hallazgo con evidencia"] --> B["Propuesta de corrección"]
    B --> C{"¿Aprobación humana?"}
    C -- "sí" --> D["Respaldo previo"]
    D --> E["Cambio mínimo"]
    E --> F["Verificación desde dentro<br/>y desde fuera"]
    F --> G["Registro con reversión"]
    C -- "no" --> H["Queda en el plan"]
    class G clave
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
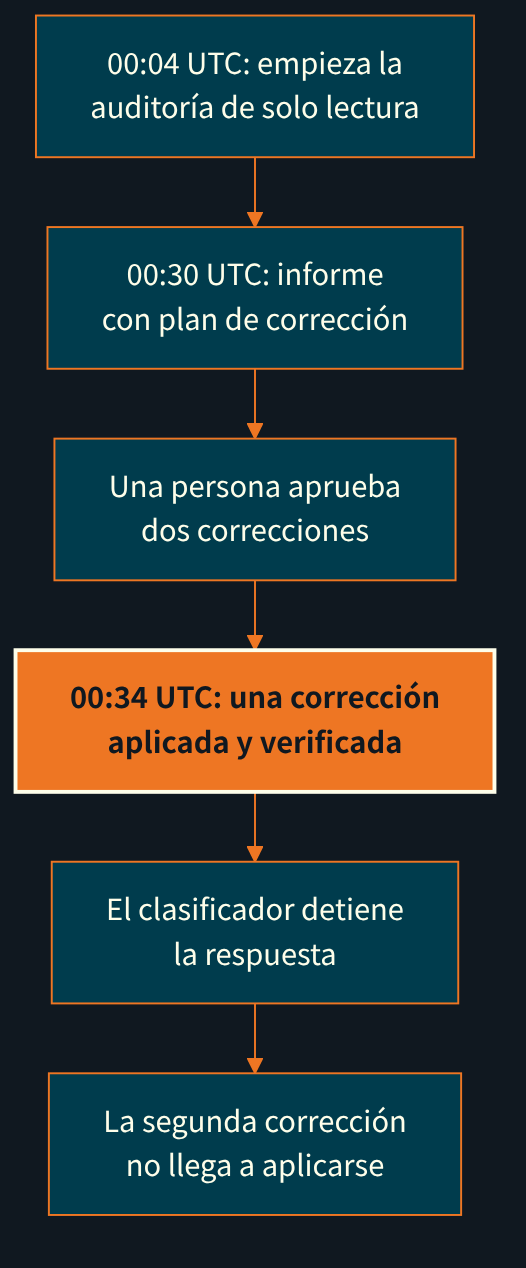
Meta-estructura Mermaid
flowchart TB
    A["00:04 UTC: empieza la<br/>auditoría de solo lectura"] --> B["00:30 UTC: informe<br/>con plan de corrección"]
    B --> C["Una persona aprueba<br/>dos correcciones"]
    C --> D["00:34 UTC: una corrección<br/>aplicada y verificada"]
    D --> E["El clasificador detiene<br/>la respuesta"]
    E --> F["La segunda corrección<br/>no llega a aplicarse"]
    class D clave
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
La corrección que sí se aplicó fue apagar un modo de depuración que mostraba información interna a cualquier visitante de una aplicación. Se respaldó la configuración, se pasó a modo de producción y se verificó desde fuera que la página pública ya no lo mostraba. Esto reduce la exposición, pero no cierra el hallazgo: la aplicación necesita una actualización, que sigue en el plan. La segunda corrección aprobada no llegó a aplicarse.
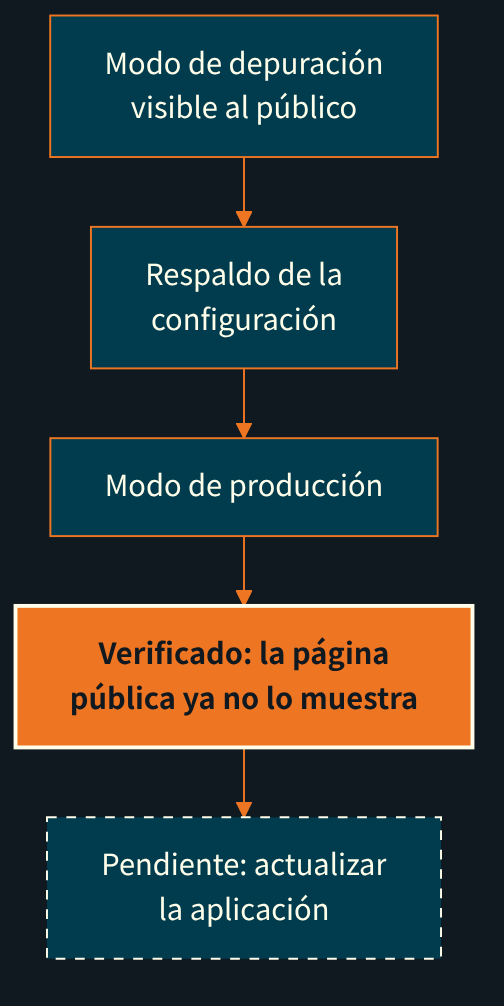
Meta-estructura Mermaid
flowchart TB
    A["Modo de depuración<br/>visible al público"] --> B["Respaldo de la<br/>configuración"]
    B --> C["Modo de producción"]
    C --> D["Verificado: la página<br/>pública ya no lo muestra"]
    D --> E["Pendiente: actualizar<br/>la aplicación"]
    class D clave
    class E fuera
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
    classDef fuera stroke:#FEFEEA,stroke-dasharray:5 5
¿Por qué se detuvo el modelo?
Dos veces, un clasificador de seguridad detuvo la respuesta del modelo. Claude Code lo informó sin ambigüedad: la respuesta fue detenida por un clasificador de seguridad y no por un error; el resto quedó retenido y los comandos pendientes no se ejecutaron. La documentación de Anthropic describe lo mismo: una negativa puede llegar a mitad de una respuesta, y lo ya generado se trata como incompleto.
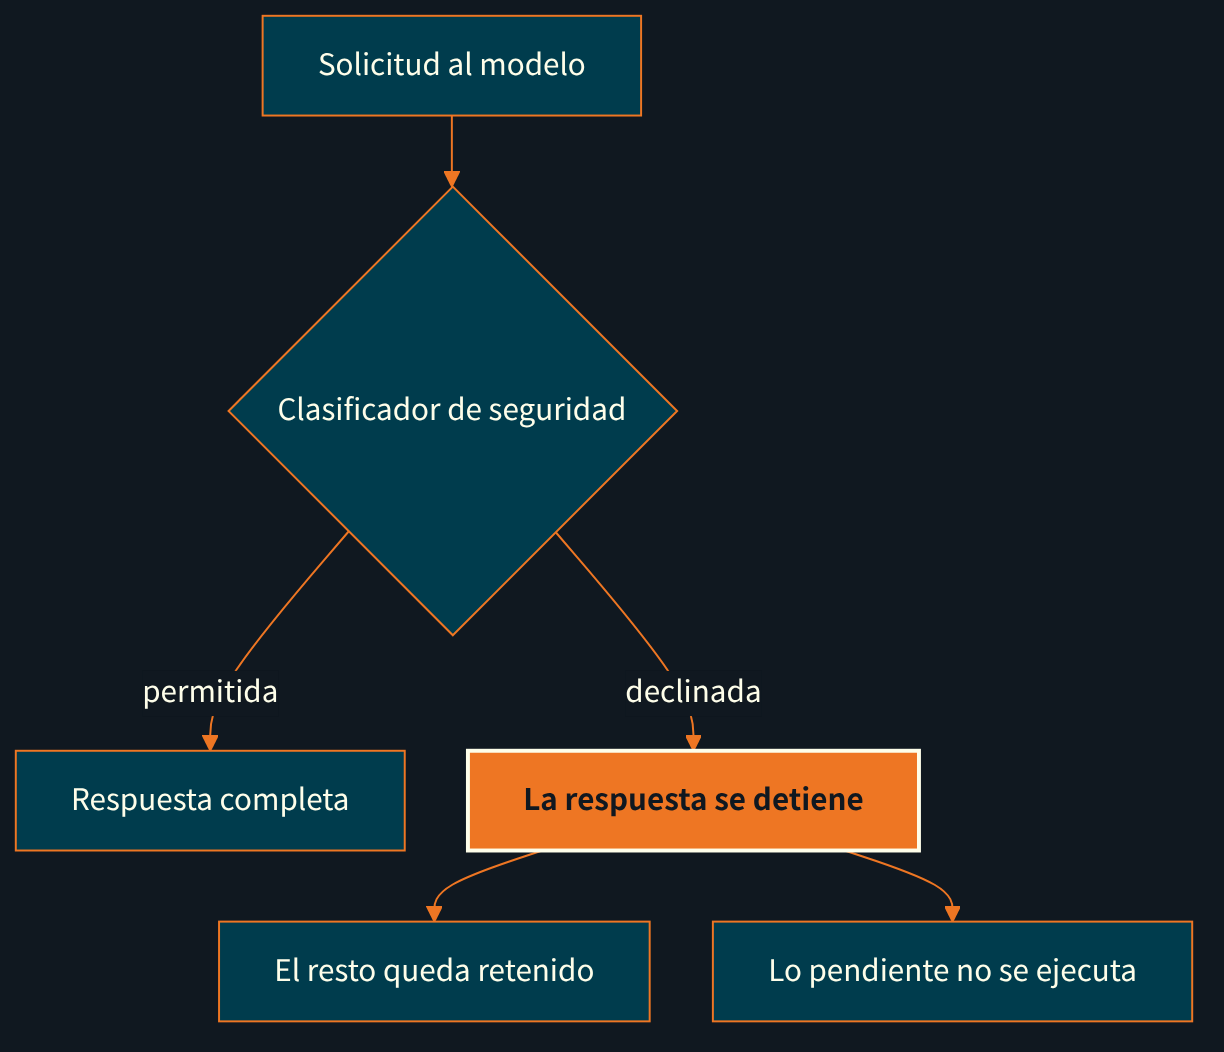
Meta-estructura Mermaid
flowchart TB
    A["Solicitud al modelo"] --> B{"Clasificador de seguridad"}
    B -- "permitida" --> C["Respuesta completa"]
    B -- "declinada" --> D["La respuesta se detiene"]
    D --> E["El resto queda retenido"]
    D --> F["Lo pendiente no se ejecuta"]
    class D clave
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
No conocemos el criterio exacto del clasificador y no vamos a especular sobre él. Lo que sí observamos es cuándo ocurrió. La primera vez, al pasar de identificar a corregir en producción. La segunda, al ampliar la revisión hacia cuentas, llaves de acceso y respaldos.
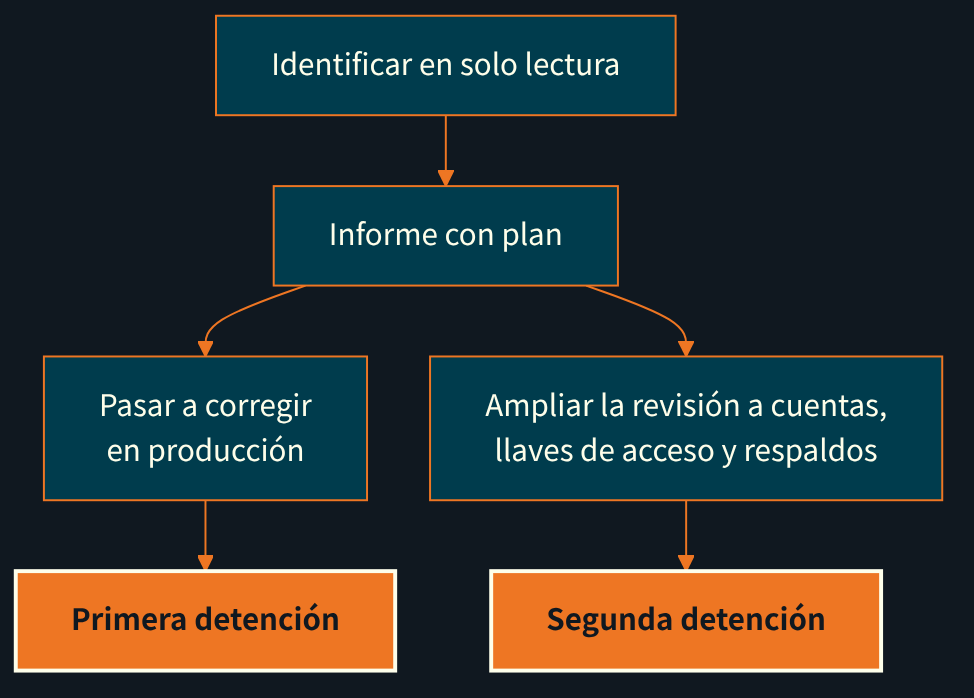
Meta-estructura Mermaid
flowchart TB
    A["Identificar en solo lectura"] --> B["Informe con plan"]
    B --> C["Pasar a corregir<br/>en producción"]
    C --> X1["Primera detención"]
    B --> D["Ampliar la revisión a cuentas,<br/>llaves de acceso y respaldos"]
    D --> X2["Segunda detención"]
    class X1,X2 clave
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
Cómo respondimos importa tanto como lo que pasó. No reformulamos la petición para rodear la negativa ni intentamos reproducir lo retenido. Lo tratamos como una señal de que esa parte del trabajo pide otro camino: que la haga una persona del equipo con sus herramientas habituales, o que espere a que el alcance y el programa de acceso lo permitan.
¿Qué sí se puede hacer y qué no?
Con este modelo, la lista de lo que no se debe hacer es más larga que la de lo que sí. Nos parece correcto que así sea. Una herramienta capaz de encontrar debilidades en minutos tiene que trabajar dentro de límites que no dependan de la buena fe de quien la usa.
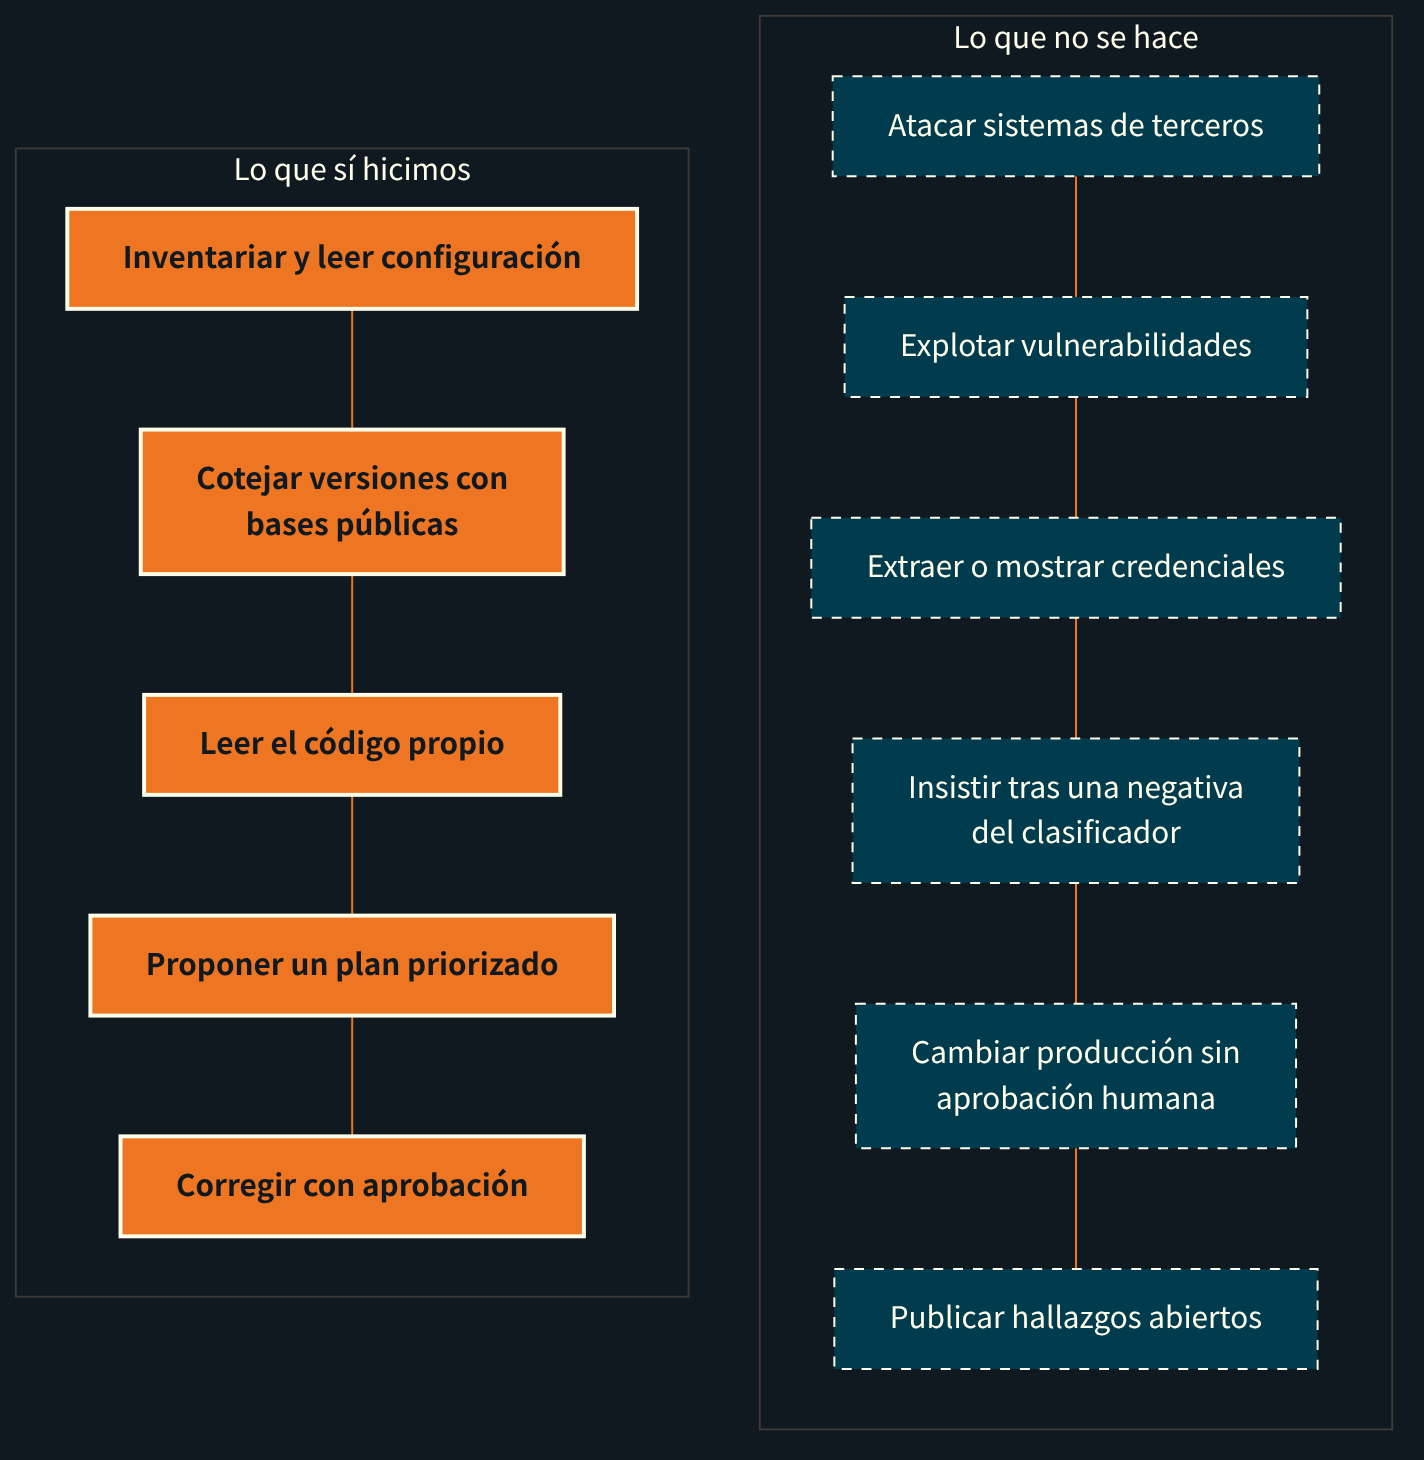
Meta-estructura Mermaid
flowchart LR
    subgraph SI["Lo que sí hicimos"]
        direction TB
        S1["Inventariar y leer configuración"]
        S2["Cotejar versiones con<br/>bases públicas"]
        S3["Leer el código propio"]
        S4["Proponer un plan priorizado"]
        S5["Corregir con aprobación"]
        S1 --- S2 --- S3 --- S4 --- S5
    end
    subgraph NO["Lo que no se hace"]
        direction TB
        N1["Atacar sistemas de terceros"]
        N2["Explotar vulnerabilidades"]
        N3["Extraer o mostrar credenciales"]
        N4["Insistir tras una negativa<br/>del clasificador"]
        N5["Cambiar producción sin<br/>aprobación humana"]
        N6["Publicar hallazgos abiertos"]
        N1 --- N2 --- N3 --- N4 --- N5 --- N6
    end
    SI ~~~ NO
    class S1,S2,S3,S4,S5 clave
    class N1,N2,N3,N4,N5,N6 fuera
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
    classDef fuera stroke:#FEFEEA,stroke-dasharray:5 5
¿Hay que verificar al verificador?
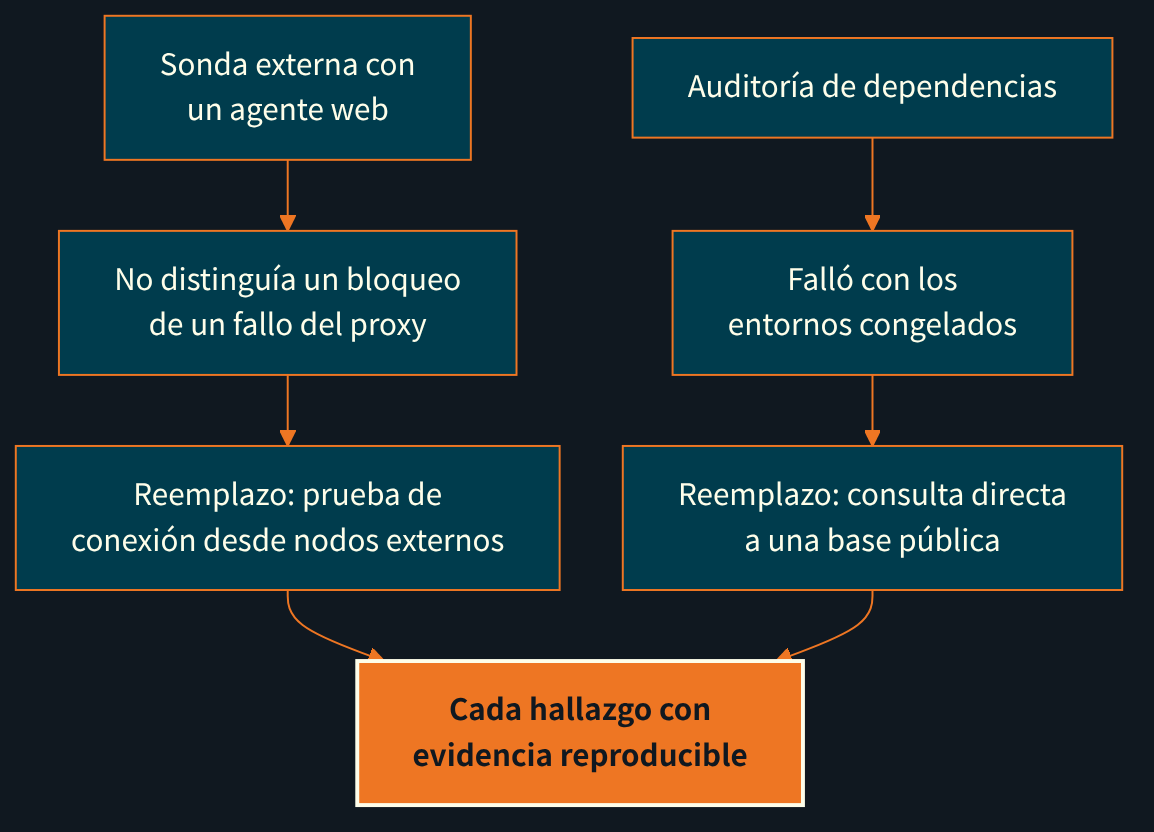
Sí. Dos herramientas de la propia sesión fallaron, y el modelo lo dejó escrito en su informe. Una sonda externa hecha con un agente web no distinguía un bloqueo real de un fallo del proxy de salida, así que se descartó y se reemplazó por una prueba de conexión desde nodos externos. La auditoría automática de dependencias falló con los entornos congelados, y se reemplazó por una consulta directa a una base pública de vulnerabilidades. El resultado es que cada hallazgo tiene evidencia que cualquiera del equipo puede reproducir.
Meta-estructura Mermaid
flowchart TB
    A["Sonda externa con<br/>un agente web"] --> B["No distinguía un bloqueo<br/>de un fallo del proxy"]
    B --> C["Reemplazo: prueba de<br/>conexión desde nodos externos"]
    D["Auditoría de dependencias"] --> E["Falló con los<br/>entornos congelados"]
    E --> F["Reemplazo: consulta directa<br/>a una base pública"]
    C --> G["Cada hallazgo con<br/>evidencia reproducible"]
    F --> G
    class G clave
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
¿Qué salvaguardas recomendamos?
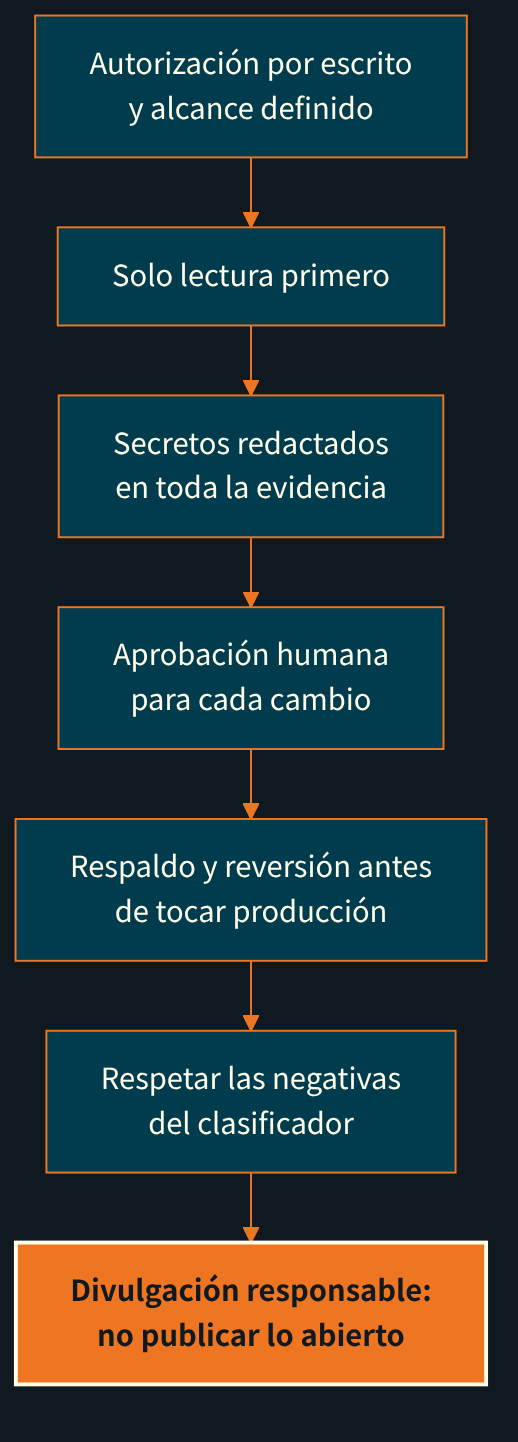
Si tu empresa va a usar IA de frontera para revisar su seguridad, estas son las siete reglas que seguimos y que recomendamos:
- Autorización por escrito y alcance definido. Qué sistemas, quién autoriza y qué queda fuera.
- Solo lectura primero. Identificar antes de tocar.
- Secretos redactados. Ninguna contraseña ni llave en la evidencia, ni siquiera en documentos internos.
- Aprobación humana para cada cambio. El modelo propone; una persona decide.
- Respaldo y reversión antes de tocar producción. Cada cambio con su forma de deshacerlo.
- Respetar las negativas del clasificador. No reformular para rodearlas.
- Divulgación responsable. Publicar el método y los conteos, nunca el detalle de lo que sigue abierto.
Meta-estructura Mermaid
flowchart TB
    A["Autorización por escrito<br/>y alcance definido"] --> B["Solo lectura primero"]
    B --> C["Secretos redactados<br/>en toda la evidencia"]
    C --> D["Aprobación humana<br/>para cada cambio"]
    D --> E["Respaldo y reversión antes<br/>de tocar producción"]
    E --> F["Respetar las negativas<br/>del clasificador"]
    F --> G["Divulgación responsable:<br/>no publicar lo abierto"]
    class G clave
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
Qué opinamos en Transgenia
Claude Mythos no es la inteligencia artificial que lo rompe todo ni un juguete. Es un instrumento potente que trabaja bajo reglas, y las reglas son parte del valor: un modelo que se detiene cuando el trabajo se acerca a lo riesgoso es más confiable que uno que nunca se detiene. Esta fue nuestra primera prueba de concepto con el Acceso de Defensa, y agradecemos la confianza que implica la verificación. Lo seguiremos usando dentro de su alcance: defender lo que poseemos o mantenemos. Si un día ampliamos ese alcance, será dentro de los niveles, las aprobaciones y la supervisión que Anthropic establezca, y lo diremos con la misma claridad que este artículo. No es nuestra única herramienta: también contamos con acceso aprobado a Daybreak Blue de OpenAI para trabajos internos de ciberseguridad autorizados.
¿Qué significa para tu empresa?
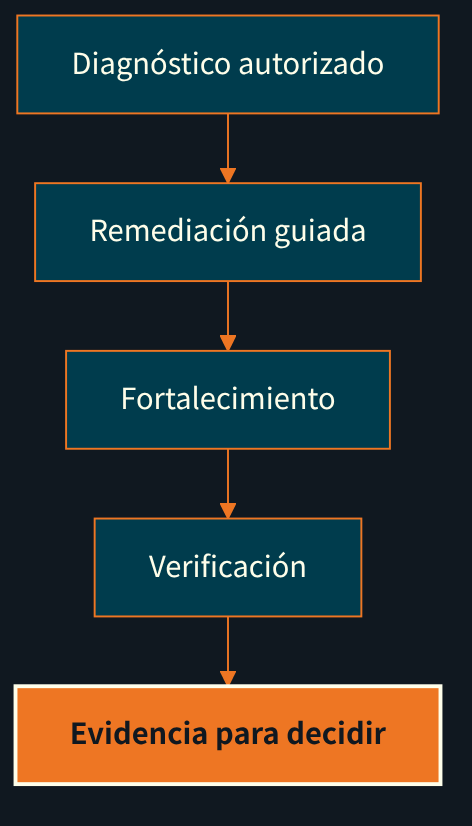
Lo que aprendimos en casa es lo que aplicamos en nuestro servicio de ciberseguridad: diagnóstico autorizado, remediación guiada, fortalecimiento y verificación, con el alcance, los permisos y los entregables por escrito. Como organización verificada con Acceso de Defensa, podemos usar los modelos más capaces de Anthropic para defender sistemas que poseemos o mantenemos. Si Transgenia mantiene los sistemas de tu empresa, ese trabajo se hace dentro de ese alcance, con tu autorización por escrito y con el mismo método: identificar antes de tocar, corregir con aprobación y entregar evidencia para decidir. Las pruebas de penetración no forman parte de ese nivel.
Meta-estructura Mermaid
flowchart TB
    A["Diagnóstico autorizado"] --> B["Remediación guiada"]
    B --> C["Fortalecimiento"]
    C --> D["Verificación"]
    D --> E["Evidencia para decidir"]
    class E clave
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
Fuentes
- Claude Mythos 5.1 (documentación de Claude Platform, Anthropic, leída el 10 de noviembre de 2026).
- Refusals and fallback (documentación de Claude Platform, Anthropic, leída el 10 de noviembre de 2026).
- Cyber Verification Program (Claude Help Center, Anthropic, leída el 10 de noviembre de 2026).
- API de avisos de seguridad de Packagist (Packagist, consultada el 9 de noviembre de 2026).
- OSV, base abierta de vulnerabilidades (consultada el 9 de noviembre de 2026).
- Notificación de Anthropic a Transgenia sobre la aprobación del Acceso de Defensa (7 de noviembre de 2026): no es pública.
- Registro interno de la auditoría (9 de noviembre de 2026): no es público; las cifras se citan tal como quedaron escritas.
Preguntas frecuentes
¿Qué es Claude Mythos 5.1?
Es un modelo de Anthropic, el mismo que Claude Fable 5.1, disponible solo para organizaciones verificadas por sus programas de verificación, como el Cyber Verification Program. Se publicó el 1 de septiembre de 2026.
¿Transgenia es una organización verificada por Anthropic?
Sí. El 7 de noviembre de 2026, Anthropic aprobó a Transgenia para el Acceso de Defensa de su Cyber Verification Program, que sirve para defender sistemas que posee o mantiene. No es una certificación ni un aval de sus servicios.
¿Cualquier empresa puede usar Claude Mythos?
No. Hay que solicitar el acceso al programa de Anthropic que cubra el caso de uso, y la verificación la decide Anthropic. Cada prueba debe estar autorizada de antemano por quien tiene autoridad sobre los sistemas.
¿Por qué el modelo detuvo dos respuestas?
Porque sus clasificadores de seguridad las declinaron. Anthropic documenta que el trabajo benigno de ciberseguridad también puede activarlos. No conocemos el criterio exacto; respetamos la negativa y seguimos por otro camino.
¿Hicieron una prueba de penetración?
No. Fue una auditoría de solo identificación sobre nuestra propia infraestructura, sin pruebas intrusivas, sin fuerza bruta, sin explotación y sin descargar datos.
¿Pueden auditar mi empresa con Claude Mythos?
Si Transgenia mantiene tus sistemas, podemos usarlo para defenderlos, dentro del Acceso de Defensa y con tu autorización por escrito. Las pruebas de penetración requieren otro nivel del programa, que hoy no tenemos. Nuestro servicio incluye diagnóstico autorizado, remediación guiada, fortalecimiento y verificación.
¿Publican las vulnerabilidades que encontraron?
No publicamos el detalle de los hallazgos que siguen abiertos. Compartimos el método, los conteos por severidad y los patrones que conviene buscar en cualquier servidor.
Siguiente paso
Si un sistema te preocupa hoy, empecemos por 15 minutos. Ubicamos qué quieres proteger, quién puede autorizar la revisión y qué evidencia necesitas para decidir. Agenda 15 minutos o revisa nuestro servicio de ciberseguridad.
Sobre el autor y Transgenia
Efraín Carreón Ortiz es Director General (Chief Executive Officer) de Centrum Transgenia, una boutique tecnológica mexicana. Está acreditado con la insignia oficial Claude Code (Claude Partner Badge) emitida por Anthropic, verificable en Credly.
Transgenia es OpenAI Select Partner dentro del OpenAI Partner Network y partner registrado en el Claude Partner Network de Anthropic. Es, además, organización verificada en el Cyber Verification Program de Anthropic, con Acceso de Defensa. Equipo: Víctor Estrada Bello, Chief PMO; Danild Johan Zambrana López, Chief Technology Officer; Jaime Lozano Castañeda, Chief Marketing Officer; Efraín Carreón Ortiz, Director General (Chief Executive Officer).
Hablemos: contacto@transgenia.org, WhatsApp +52 55 8034 0405, agenda de 15 minutos o la página de contacto.
Sigue leyendo
- Ciberseguridad para empresas en México: el servicio que aplica este método.
- Limpiar el malware no es cerrar la brecha: otro caso de seguridad, en un WordPress comprometido.
- Inventario de infraestructura MCP: la primera vez que auditamos lo nuestro con Claude.
- ¿Tu sitio dice lo mismo de tu empresa en cada página?: también ahí nos auditamos primero.
- meet.transgenia.org: cómo dejamos de pagar Read AI: un servicio propio, endurecido antes de abrirlo.
- De 5 horas a 13 segundos: barandales y respeto al trabajar con un agente autónomo.
- Cotizaciones con IA y aprobación humana: la misma regla, una persona aprueba antes de actuar.
- Cómo gobernamos un equipo de doce agentes de IA: el gobierno detrás de este trabajo.
Hashtags: #ClaudeMythos #Ciberseguridad #CiberseguridadConIA #Anthropic #CyberVerificationProgram #ProjectGlasswing #IAResponsable #PyMEsMéxico