本文面向在墨西哥、台湾或东南亚注册的中资企业的业务与技术读者,平台所依赖的OpenAI服务在中国大陆不可用。一年多来,Transgenia(特兰斯赫尼亚)按席位为一款人工智能(AI)会议助手付费;自2026年10月26日起,我们的会议改在自建平台上转录,只用一个语音识别模型,会议纪要由人审阅,商业信号则进入我们的企业资源计划(ERP)系统。下面是我们建了什么、按标价要花多少钱,以及它目前还不能做什么。
查看 Mermaid 源码
flowchart LR
    A["1. 参会者知情同意
后进入"] --> B["2. 其浏览器只采集
本人麦克风"]
    B --> C{"3. 主持人
批准"}
    C -->|"取消"| X["音频保留
不处理"]
    C -->|"批准"| D["4. gpt-transcribe
单一模型"]
    D --> E["5. GPT-5.4 mini
会议纪要草稿"]
    E --> F{"6. 主持人批准
收件人"}
    F -->|"批准"| G["含纪要与转录文本
的邮件"]
    E --> H["7. 商业信号
附原文引用"]
    H --> I[("Odoo
Laboratorio IA")]
meet.transgenia.org是什么?
meet.transgenia.org是Transgenia的内部会议平台。视频通话由8x8的JaaS在页面内提供;包在外面的应用是一个用Go语言写的单二进制程序,带一个SQLite数据库,运行在我们原有服务器上的一个无特权容器里。这个应用负责创建会议室、为每场会议签发权限、从每位参会者的浏览器采集音频、通过OpenAI的应用程序接口(API)转录、撰写会议纪要草稿,并在主持人批准后用邮件发出纪要,同时把商业信号送到我们的Odoo。
我们不是从零开始。代码是Cliff Brake于2026年4月发布的jaas-app项目的公开fork,经作者许可使用。我们加上的部分都在同一个公开仓库里:带签名的webhook(回调通知)、置于Cloudflare Access(身份访问控制服务)之后的按用户会议室、需主持人批准的音频采集、一个会议纪要worker(后台处理进程)、可配置的保留期限、带我们品牌识别的HTML邮件,以及与Odoo的同步。任何人都可以阅读这些改动,连同其测试和拉取请求(PR)的说明。
它也不是一款产品。它是我们日常使用的工具,也是我们为客户实施方案的试验场:一个把数据留在自己家里的会议平台,一次只花几美分的转录,以及一份没人读过就不会发出的会议纪要。
我们为什么不再为Read AI付费?
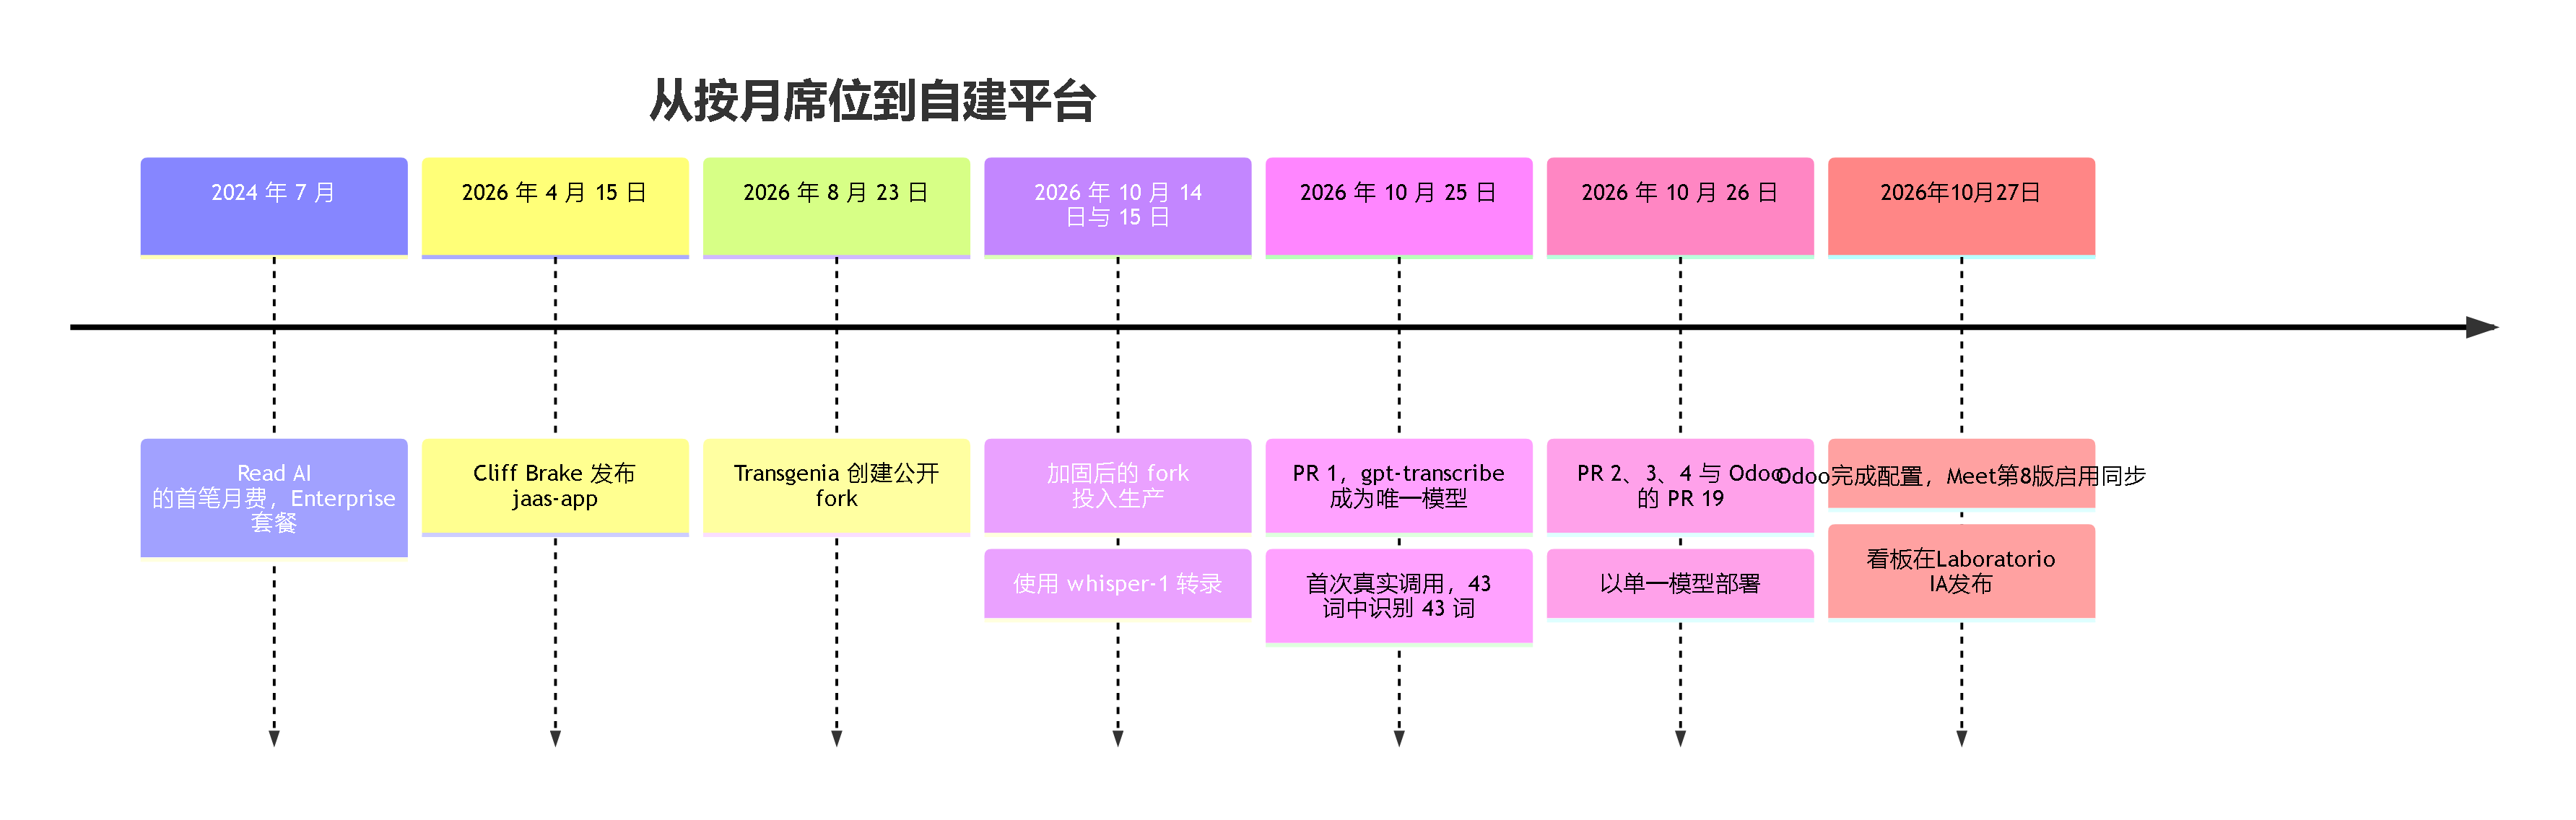
我们从2024年7月起为Read AI付费,直到2026年。它是一款好产品,写这篇文章不是为了贬低它:它兑现了承诺。我们停止付费有四个原因,都与它的质量无关。
- 计费模式。 按其2026年10月26日的价格页面,Enterprise套餐按月付费时每席位每月29.75美元(按年付费为22.50美元),且要求至少5个许可。一周开20场会和一周一场不开,付的钱一样。
- 数据放在哪里。 与客户会议的录音和转录文本留在第三方的云端,受其条款约束。我们希望音频、转录文本和会议纪要都放在自己的服务器上,受我们的隐私声明约束,删除期限由我们自己设定。
- 一份会议纪要能用来做什么。 躺在邮箱里的纪要只是一份文档。能喂给客户关系管理(CRM)系统的纪要则是商业信号:一笔隐约提到的续约、某人提出的配套服务、一个值得关注的流失风险。我们要的是后者,而这要求控制输出格式。
- 我们是做什么的。 Transgenia为墨西哥中小企业实施AI。自建会议平台,是在向别人推荐之前,弄清它花多少钱、在哪里出错、需要哪些护栏的踏实办法。
查看 Mermaid 源码
timeline
    title 从按月席位到自建平台
    2024 年 7 月 : Read AI 的首笔月费,Enterprise 套餐
    2026 年 4 月 15 日 : Cliff Brake 发布 jaas-app
    2026 年 8 月 23 日 : Transgenia 创建公开 fork
    2026 年 10 月 14 日与 15 日 : 加固后的 fork 投入生产 : 使用 whisper-1 转录
    2026 年 10 月 25 日 : PR 1,gpt-transcribe 成为唯一模型 : 首次真实调用,43 词中识别 43 词
    2026 年 10 月 26 日 : PR 2、3、4 与 Odoo 的 PR 19 : 以单一模型部署
    2026年10月27日 : Odoo完成配置,Meet第8版启用同步 : 看板在Laboratorio IA发布
转录和会议纪要是如何运作的?
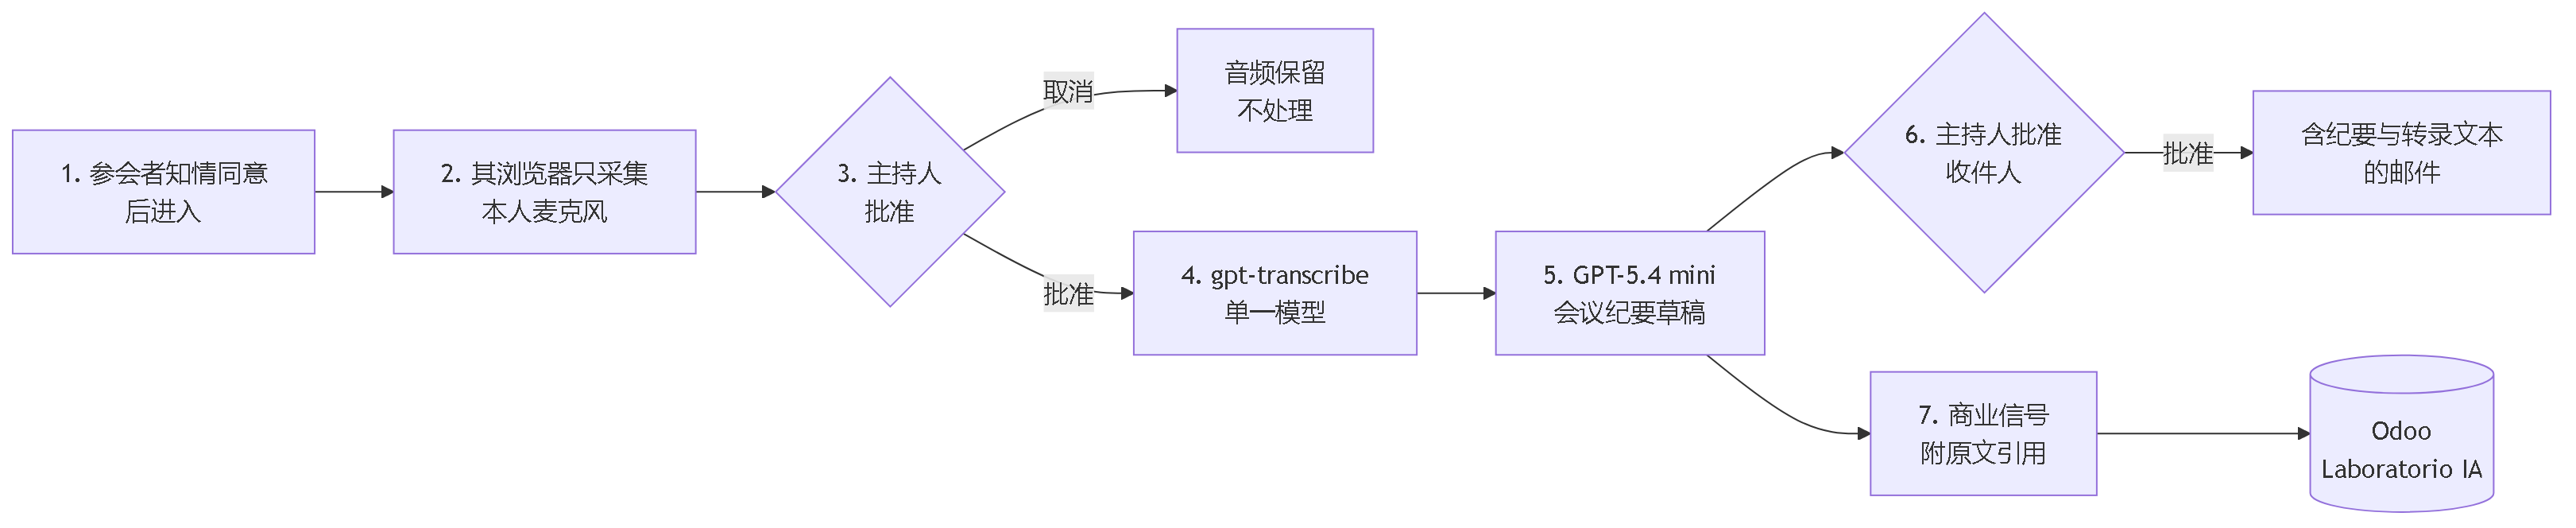
整个流程有七步。关键的是两处批准:主持人不发起就没有转录,主持人不批准就没有邮件。
- 知情同意后进入。 每位参会者通过会议室链接进入,填写姓名和邮箱,并接受转录提示。进入前选择语言(西班牙语、英语或混合)和麦克风,还可以做一次本地信号测试,该测试不上传音频,也不调用任何模型。
- 只采集本人的麦克风。 每个人的浏览器只录本人的麦克风,且只在未静音时录。它请求48 kHz单声道,每15秒上传一个片段,每10分钟轮换一条音轨。结束时提交一份汇总清单,含片段数量、大小和哈希值:仅凭沉默并不能证明一条音轨是完整的。
- 批准处理。 主持人检查采集结果并批准。在此之前,没有一秒音频被发送给任何模型。主持人也可以取消:音频按保留策略保存,不做处理。
- 只用一个模型转录。 音频通过官方的Go语言SDK(软件开发工具包)送到OpenAI的转录模型gpt-transcribe。没有自动切换到其他模型的后备方案,也没有隐藏的重试:如果一个请求处于不确定状态,由人来复核。转录的时间精度到时间窗,而不到单个词,并且不识别谁在说话。
- 撰写会议纪要草稿。 GPT-5.4 mini接收合并后的转录文本,返回严格的JSON结构:摘要、决定、任务、风险,以及附原文引用的情绪判断。调用走Responses API(OpenAI的响应接口),并选择不在OpenAI保存对话。引用在转录文本中不存在的纪要,会在送达任何人之前被拒绝。
- 审阅并批准发送。 会议室所有者收到一封只说明“纪要已就绪”、不含内容的邮件。他在纪要页面看到建议的参会者名单,移除不应收到的人,然后批准。每个地址只收到一次纪要和完整转录文本,回复地址指向主持人。
- 提取商业信号。 在撰写纪要的同一次请求里,模型提出至多12条商业假设,每条附一处可核实的引用。这些假设不会出现在发给参会者的邮件中:它们只存在于主持人的内部视图和Odoo里,由人接受或丢弃。
保存什么、保存多久:转录文本、会议纪要和参会者邮箱保留9个月;原始音频私密保存至多30天,全局配额10 GiB,主持人删除会议室则提前删除。不存在视频录像:我们不录视频。服务器日志只记录每个请求的方法、路径、状态和耗时,从不记录内容,并有一项自动化测试来验证这一点。
有三家第三方参与:8x8提供视频通话,OpenAI处理音频并撰写纪要,Cloudflare负责管理面板的身份验证。我们的隐私声明就是这样写的,它是我们唯一的公开承诺。
用OpenAI的API转录一场会议要花多少钱?
下列数字是各供应商公布的标价,读取于2026年10月26日。不含服务器(我们本来就有)、工程投入,以及审阅者的时间。
| 项目 | 标价 | 来源 |
|---|---|---|
whisper-1,我们起步时用的模型;OpenAI已将其标记为deprecated(弃用) | 每分钟音频0.006美元 | OpenAI,模型页面 |
gpt-transcribe,目前使用的模型 | 每分钟音频0.0045美元 | OpenAI,模型页面 |
| GPT-5.4 mini,撰写纪要的模型 | 每百万输入token 0.75美元,每百万输出token 4.50美元 | OpenAI,模型页面 |
| Read AI,Enterprise套餐 | 每席位每月29.75美元(按月付费)或22.50美元(按年付费),至少5个许可 | read.ai,价格页面 |
一场60分钟的会议,用gpt-transcribe转录花0.27美元(60乘以0.0045),用whisper-1则要0.36美元。纪要的费用取决于token(模型计量文本的单位)数量:如果这一小时的转录文本占12,000个输入token,纪要占2,000个输出token,就是0.009美元加0.009美元。这是假设而非测量:精确的计数由API在每次调用时报告,我们的应用按请求逐条保存。
纯算术的比较是这样的:每月29.75美元,即一个Enterprise席位的价格,相当于按标价用gpt-transcribe转录110小时音频(29.75除以0.27)。一个有5个许可的团队,也就是该套餐的下限,每月付的钱够转录550小时以上。
两点提醒。其一:我们的应用记录每个请求及供应商报告的用量,但成本字段留为NULL(空值),直到与账单对账为止;我们还没有公布每场会议的实际成本,因为还没有测量。
其二:每分钟的价格不是总成本。有服务器,有工程师的工时,还有一个逐份阅读纪要的人。这些成本在任何替代方案里都存在;不同的是,在这里由我们自己掌控。
有哪些证据表明它能运作?
本文的每项断言都有公开来源或带日期的内部记录。时间顺序如下。
| 日期 | 事实 | 核查处 |
|---|---|---|
| 2026年4月15日 | Cliff Brake发布jaas-app,即我们所基于的应用。 | GitHub,cbrake/jaas-app |
| 2026年8月23日 | Transgenia创建公开fork。 | GitHub,Transgenia/jaas-app |
| 2026年10月14日和15日 | 14个提交加固了fork,并以whisper-1把它带到生产环境。 | fork的提交历史 |
| 2026年10月25日 | PR #1:受控音频采集,只用一个转录模型。39个文件,新增4,592行。完整的Go测试套件在137.7秒内全部通过;Node端采集测试11项通过11项。 | fork的PR #1 |
| 2026年10月25日 | 首次用15秒合成音频真实调用gpt-transcribe:2,105毫秒内返回,43个参考词识别出43个,编辑距离为零。 | 试点的内部记录 |
| 2026年10月26日 | PR #2和PR #3:取消JaaS的并行转录,完成发布并移交给操作者。至多45秒、两条音轨的实况测试,在发布会话中审阅并通过。以单一模型部署到生产环境,30天保留期已验证。 | fork的PR #2和PR #3 |
| 2026年10月26日 | PR #4(向Odoo同步商业信号,14个文件,1,517行)以及Odoo仓库的PR #19(插件和看板):20项测试,0失败,0错误。 | fork的PR #4与我们的Odoo仓库的PR #19 |
| 2026年10月27日 | 在Odoo中对接收端做隔离演练:20项测试通过20项。私有备份与恢复,核验3,222个附件,无一缺失。 | 内部记录 |
| 2026年10月27日 | Odoo配置在三次未写入任何数据的HOLD之后达到GO:一位负责人的资料邮箱与其Meet登录不一致,解决方式是在Meet内置一张私有的一对一映射表(fork的PR #5,架构版本8,9个文件、620行,CI通过),而不是改动Odoo账户。技术密钥范围受限,有效期最长90天。 | fork的PR #5;内部记录 |
| 2026年10月27日 | Meet第8版上线,仅在队列为空时才启用同步。“会议与商机”看板已在Laboratorio IA发布;只读诊断显示两个账户各9个透视视图全部正常,1,681行日志中0个异常。首场真实会议的同步:截稿时仍待完成。 | 内部记录;10月27日在Odoo中的读取 |
这些证据不能证明的:两人同时说话、有噪音或有口音时的准确度,以及每场会议的实际成本。15秒合成音频是一次集成测试,不是质量测量。质量要在使用中、用真实会议来评估,有了数字我们再讲。
查看 Mermaid 源码
flowchart TB
    G1["1. 源码
代码就是审阅过的那份"] --> G2["2. 数据与迁移
一致的快照与 v6 演练"]
    G2 --> G3["3. 备份
通过恢复来检验"]
    G4["4. 集成测试
对模型的一次真实调用"] --> G5["5. 隐私
声明与保留期限一致"]
    G5 --> G6["6. 部署
没有活动采集的时间窗"]
    G3 --> D{"六个 GO?"}
    G6 --> D
    D -->|"是"| OK["部署并通过读取
真实状态来验证"]
    D -->|"任一 HOLD"| NO["什么都不改
保留证据"]
商业信号是如何到达Odoo的?
留在邮箱里的纪要会被遗忘。所以PR #4和Odoo插件只做一件事:把带引用的商业假设送到一个由人来决定的地方。
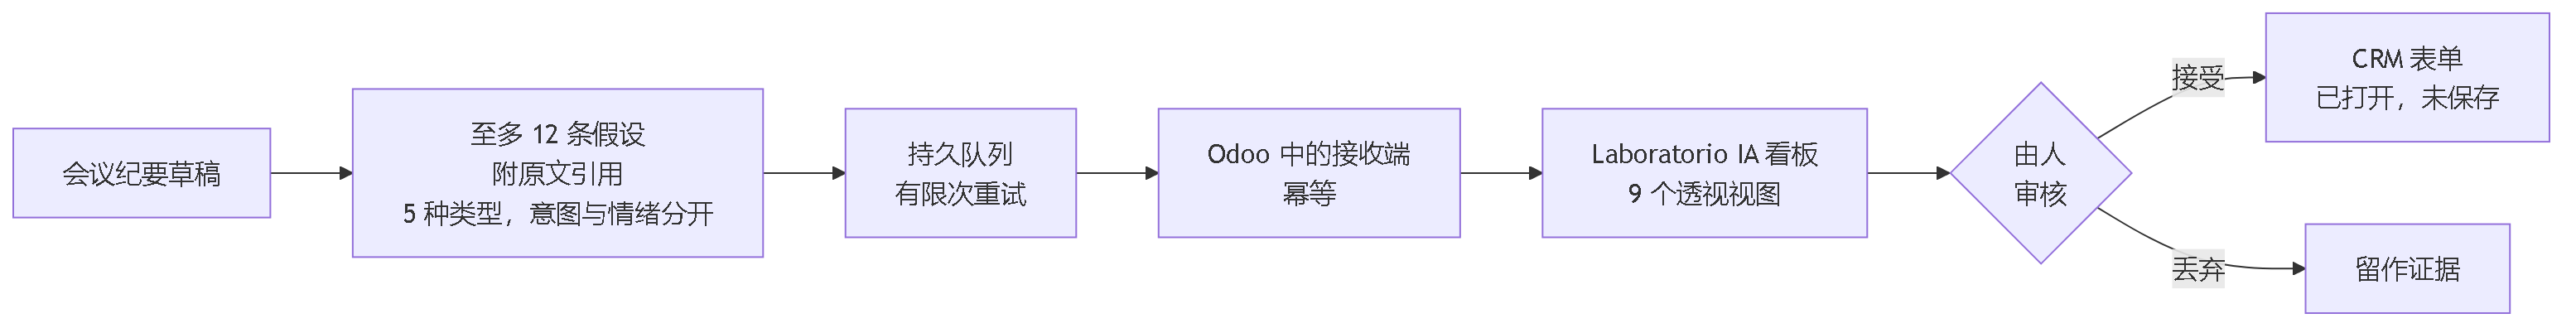
模型每场会议至多提出12条信号,分五类:续约、扩展、配套服务、新需求和流失风险。每条信号带一处转录原文引用、一个意图、一个情绪倾向和一个置信度,分别放在独立字段里。规则写在数据契约中:单凭正面情绪不等于购买意图,发言人身份始终标记为未验证。
信号通过一条带有限次重试的持久队列,送到Odoo中一个幂等的接收端(同一条信号重复送达不会重复记录):新会议绝不会继承另一场会议的客户或审核结果。在Odoo里,它们存放在Laboratorio IA群组中,设有读者、审核者和管理员角色,外加一个没有通用读取权限的技术账户。看板有9个透视视图:分析覆盖率、审核情况、已请求和已验证的报价、未排除的风险、需求类型、意图与态度,以及按客户和按服务划分的需求。
查看 Mermaid 源码
flowchart LR
    M["会议纪要草稿"] --> S["至多 12 条假设
附原文引用
5 种类型,意图与情绪分开"]
    S --> Q["持久队列
有限次重试"]
    Q --> R["Odoo 中的接收端
幂等"]
    R --> T["Laboratorio IA 看板
9 个透视视图"]
    T --> P{"由人
审核"}
    P -->|"接受"| C["CRM 表单
已打开,未保存"]
    P -->|"丢弃"| E["留作证据"]
它刻意不做的事:不创建商机,不创建任务,不发送邮件。接受一条信号是人的决定;当有人接受时,一个按钮会用Odoo的常规权限打开一个CRM表单,由这个人决定是否保存。同步worker默认关闭,也不会重新生成旧的分析:重新处理一场会议是单独的操作,成本另计。
完成集成花了什么代价。 集成在2026年10月27日(墨西哥时间26日夜间)完成,过程并不顺利,所以我们如实记录。在Odoo中配置数据源时连续返回三次HOLD,且没有写入任何数据:两个负责人邮箱相同、按邮箱找不到某个用户,最后是一个账户的Meet登录与Odoo登录一致,却与资料邮箱不一致。最省事的做法是直接修改Odoo里的那个邮箱;但指令是不要动Odoo里的任何东西。解决方案是一张放在Meet内部的私有一对一映射表,只在向Odoo发送时转换负责人邮箱:负责人不在映射表中则发送失败并停止,一个不可变的摘要也防止重试时更换负责人。这就是fork的PR #5,CI通过,打开六分钟后即合并。
接着是技术密钥:又是两次HOLD,因为我们Odoo中安装的一个模块覆盖了生成密钥的方法,辅助脚本在弄清那段代码的作用之前拒绝继续。读完代码、调整脚本后,第三次尝试返回GO。密钥范围受限,有效期最长90天,保存在一个不会被打印出来的文件里。
Meet第8版先在同步关闭的状态下上线。只有在确认发件队列为空、并且操作者书面声明了四件事之后才启用同步:没有录音的时间窗口、基于30天声明的知情同意、信号由人工审核、客户关联由人工完成。没有排入任何一场历史会议。看板由人发布,而不是由安装程序发布。第一次查看时透视视图报错:打开看板的账户没有Meet的读取群组,而后端测试是用另外两个账户通过的。补上角色后,9个透视视图全部正常,并留下一条书面教训:IFERROR背后的“无数据”并不能证明数据库是空的。
截至这篇日志发布,集成已启用,并用合成数据完成验证。第一场真正进入Odoo的会议将是尚缺的证据,发生时我们会公布。
它目前还不能做什么?
这份清单是在有人问起之前写好的。
- 不识别谁在说话。 发言归属来自采集每个麦克风的会话名称,而非声纹识别。如果两个人共用一个麦克风,该音轨会被标记为共用,没有人会编造发言人标签。
- 没有每场会议的实际成本。 用量记录是有的,但成本在与账单对账之前留为NULL。等它成为测量结果而不是按标价的推算时,我们再公布数字。
- 没有用困难的会议测量过。 集成测试用的是合成音频,实况测试不到一分钟。质量评估在使用过程中进行。
- 还没有同步过一场真实会议。 通往Odoo的链路已启用,并用合成数据和只读诊断做过测试;第一场获授权并进入看板的会议才是证据,有了再写。
- 未经批准不发送纪要,这一点不会改变。 这是设计决定,不是功能限制。
- 它不是一款产品。 它是我们的工具,代码是公开的;我们向客户提供的是在其自有基础设施上实施,而不是在我们这里开一个账户。
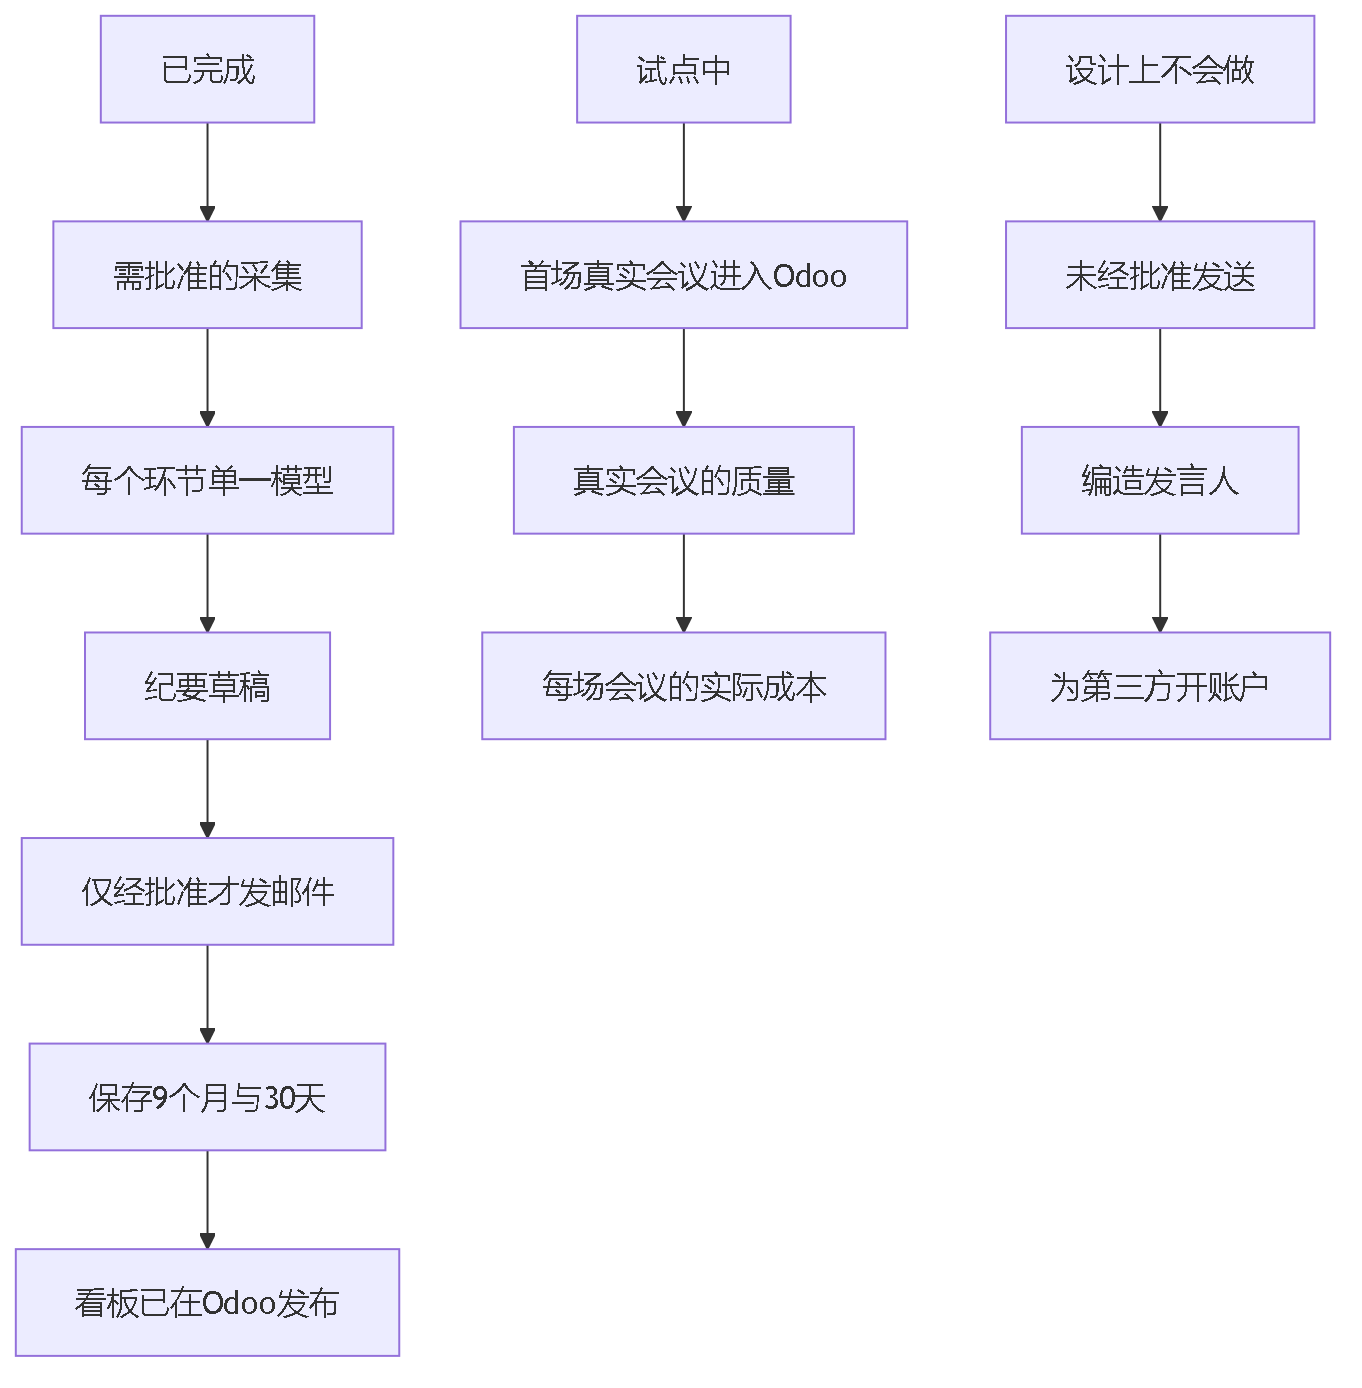
查看 Mermaid 源码
flowchart TB
    HECHO["已完成"] --> H1["需批准的采集"] --> H2["每个环节单一模型"] --> H3["纪要草稿"] --> H4["仅经批准才发邮件"] --> H5["保存9个月与30天"] --> H6["看板已在Odoo发布"]
    PILOTO["试点中"] --> P1["首场真实会议进入Odoo"] --> P2["真实会议的质量"] --> P3["每场会议的实际成本"]
    NUNCA["设计上不会做"] --> N1["未经批准发送"] --> N2["编造发言人"] --> N3["为第三方开账户"]
在生产环境运营AI智能体,我们学到了什么?
这个项目由两个AI智能体和一位拥有管理员权限的人共同操作,各司其职。
OpenAI的编程智能体Codex以只读模式诊断服务器并准备每个脚本:没有sudo(管理员提权),不接触密钥,不碰生产环境。一个人复制每个代码块,以管理员身份执行,再把结果贴回去。
Anthropic的编程智能体Claude Code根据那些会话的记录、公开的PR和我们的账目写了这篇文章,并通过了本站的编辑关口。OpenAI的模型负责转录和撰写纪要;Anthropic的模型负责审阅和写作。我们是两家的合作伙伴,各自用在它能发挥作用的地方。
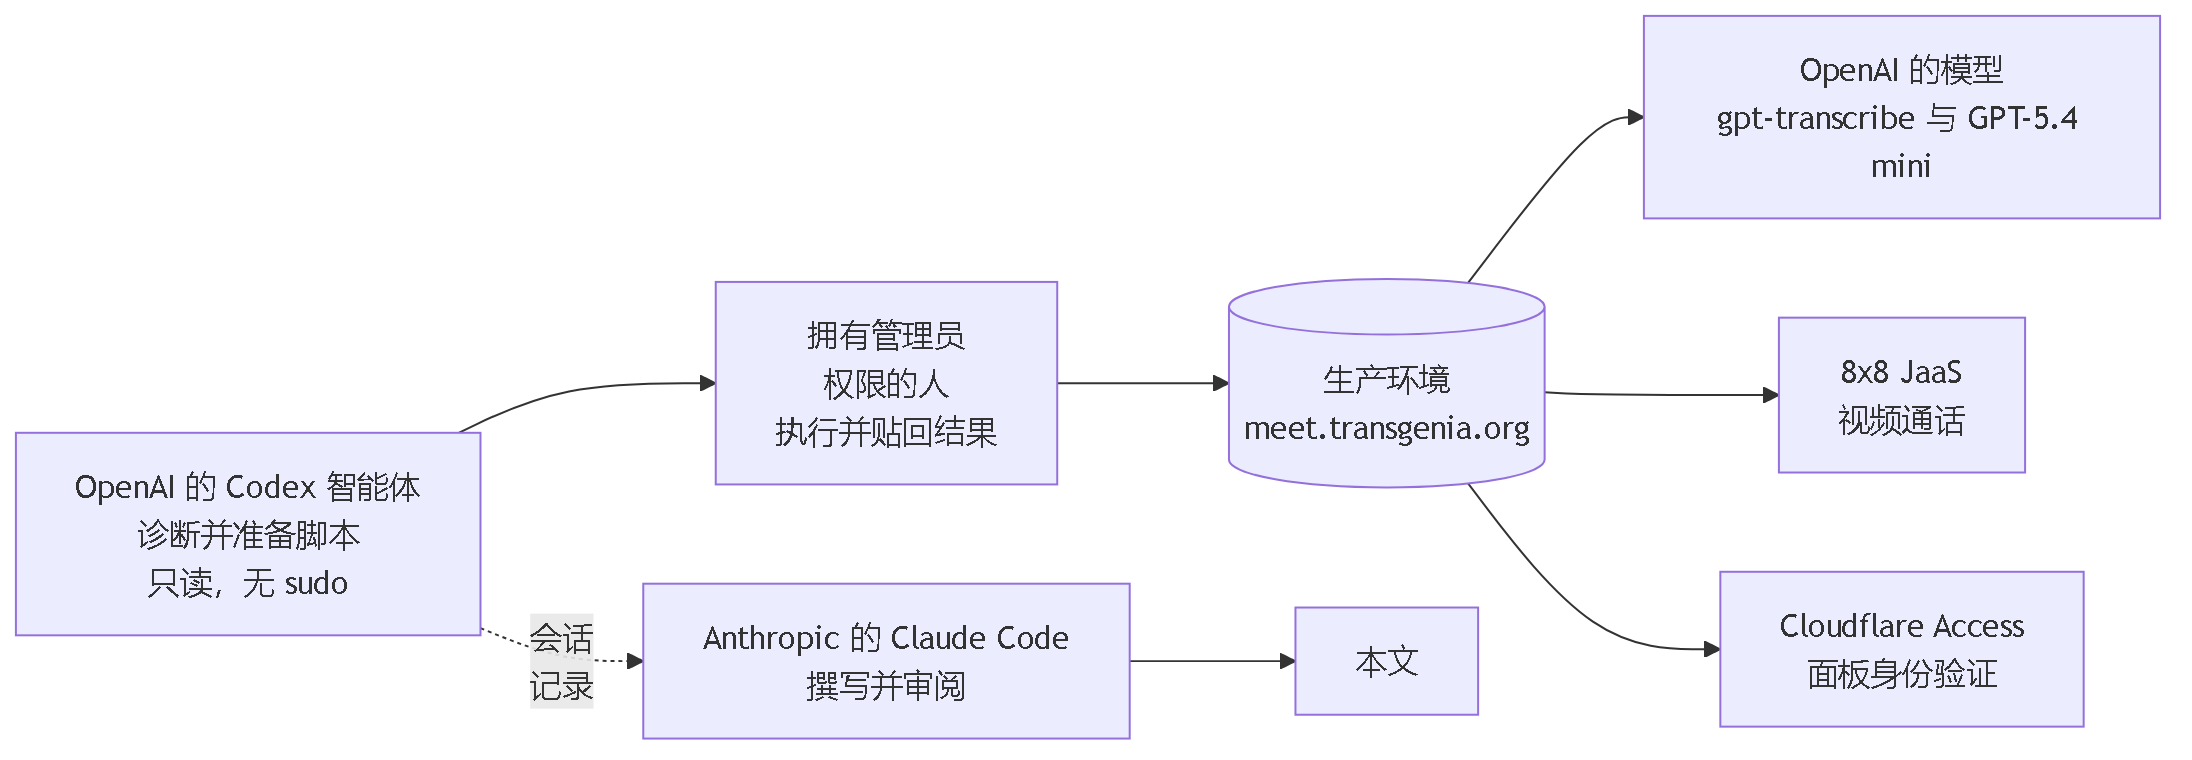
查看 Mermaid 源码
flowchart LR
    CX["OpenAI 的 Codex 智能体
诊断并准备脚本
只读,无 sudo"] --> H["拥有管理员
权限的人
执行并贴回结果"]
    H --> P[("生产环境
meet.transgenia.org")]
    P --> OA["OpenAI 的模型
gpt-transcribe 与 GPT-5.4 mini"]
    P --> X8["8x8 JaaS
视频通话"]
    P --> CF["Cloudflare Access
面板身份验证"]
    CC["Anthropic 的 Claude Code
撰写并审阅"] --> ART["本文"]
    CX -.->|"会话
记录"| CC
这次运营得出的规则可以归纳成一份清单:
- NV的意思是未验证,绝不是零。 读不到的计数器按未验证上报,而不是按空值上报。
- PR变绿不等于已部署。 “不要把PR变绿、合并、文件存在或某个单元启动当作已部署”是一条原话指令,并且得到了遵守:每次发布都通过读取服务的真实状态来验证。
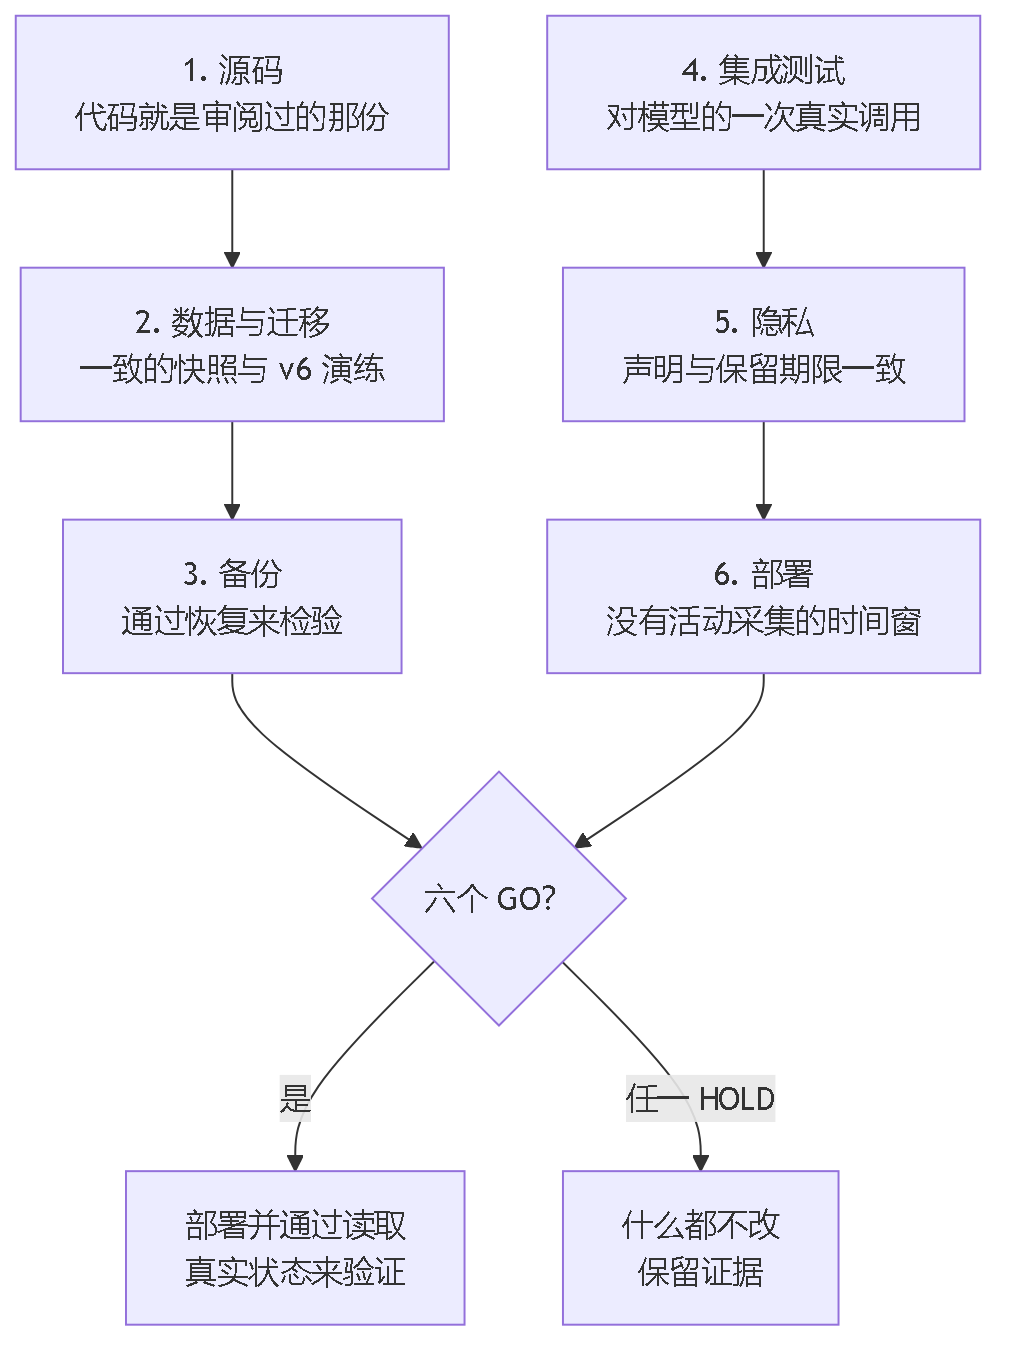
- 六道关口,各自给出GO(通过)或HOLD(暂停): 源码、数据与迁移、备份、集成测试、隐私和部署。操作者的脚本默认以计划模式运行,部署选项在六道关口全部GO之前处于锁定状态。
- 备份要靠恢复来检验。 Odoo数据库先被恢复到一个私有副本,并在安装任何东西之前清点了3,222个附件。
- 绝不盲目回滚。 旧镜像不认识批准和取消这两列;一次天真的回滚会在未经许可的情况下处理掉待批准的采集。
- 密钥是文件。 它们从未经过聊天、命令行参数或日志;智能体只确认它们存在。
如何在你的企业里复制这套方案?
我们为自己做的这一套,可以在一家墨西哥中小企业里实施,需要三个条件:一台自有服务器或一个小型VPS(虚拟专用服务器)、一把专供该服务使用的OpenAI API密钥,以及一个能接收信号的CRM(我们用的是Odoo社区版)。第四个条件不是技术性的:一个在每份纪要发出之前批准它的人。
典型的项目从企业真实的会议流程入手:谁召集会议、会上决定什么、这些决定应该去往哪里。然后再决定是像我们这样自建平台,还是把转录接入你们已在使用的视频会议工具。不变的是原则:数据留在自己家里,每个环节只用一个模型,人工批准,信号落到CRM里。
如果你想为自己的企业评估这套方案,AI实施页面说明了我们的工作方式,联系表单会送达一个真实的人。
Transgenia(特兰斯赫尼亚)的立场是什么?
没有人能自己建的时候,按席位付费是合理的;有人能建的时候,按用量付费才合理。一个Read AI席位每月的费用,相当于按标价转录110小时,而我们团队每月转录的时长达不到110小时。
但根本的论点不是价格:与客户开会的音频是客户的数据,我们宁愿它放在自己的服务器上,删除期限写在公开声明里,也不愿它放在第三方的账户里。对来问我们的人,我们给的也是同样的建议。
资料来源有哪些?
- Transgenia/jaas-app的PR #1:受控音频采集与单一自动语音识别(ASR)模型试点(2026年10月25日)。
- PR #2:取消JaaS并行转录与重复脚本加载(2026年10月26日)。
- PR #3:生产试点准备与操作者交接(2026年10月26日)。
- PR #4:带证据的商业信号与Odoo同步(2026年10月26日)。
- 我们Odoo仓库的PR #19(私有仓库,无公开链接):Laboratorio IA(AI实验室)中的商业智能看板,2026年10月26日。其测试数据也记录在公开的PR #4说明中。
- cbrake/jaas-app,Cliff Brake的原始项目。
- gpt-transcribe,模型页面与每分钟价格(OpenAI,读取于2026年10月26日)。
- whisper-1,模型页面、价格与deprecated状态(OpenAI,读取于2026年10月26日)。
- GPT-5.4 mini,模型页面与每百万token价格(OpenAI,读取于2026年10月26日)。
- Read AI,价格页面(读取于2026年10月26日)。
- Transgenia隐私声明:会议与会议纪要(meet.transgenia.org)。
- meet.transgenia.org,公开入口页面。
- 试点的内部记录(2026年10月25日和27日):不公开;数字按记录原文引用。
- Transgenia/jaas-app的PR #5:保留Odoo账户的私有负责人映射表(2026年10月27日)。
常见问题有哪些?
meet.transgenia.org是什么?
它是Transgenia的内部会议平台:视频通话跑在8x8的Jitsi as a Service上,转录用OpenAI的gpt-transcribe,纪要草稿由GPT-5.4 mini撰写,商业信号进入我们的Odoo。代码是Cliff Brake的jaas-app项目的公开fork。它不是对外销售的产品,而是我们的工具和为客户实施方案的试验场。
为什么不再为Read AI付费?
因为按席位计费的模式(Enterprise套餐每月29.75美元,至少5个许可),因为我们希望音频和纪要放在自己的服务器上、受自己的隐私声明约束,也因为我们需要纪要去喂CRM,而不是留在邮箱里。与它的质量无关:它兑现了承诺。
用OpenAI的API转录一小时会议要花多少钱?
按OpenAI 2026年10月26日的标价,用gpt-transcribe是0.27美元(每分钟0.0045美元),用whisper-1是0.36美元。纪要按token计费:在GPT-5.4 mini上,12,000个输入和2,000个输出token约合两美分。不含服务器、工程和人工审阅,我们每场会议的实际成本也尚未对账。
会议纪要由哪个模型撰写?
GPT-5.4 mini,通过OpenAI的Responses API调用,并选择不保存对话。它返回严格的JSON结构,含摘要、决定、任务、风险以及附原文引用的情绪判断。引用在转录文本中不存在的纪要,会在展示给任何人之前被拒绝。
音频、转录文本和纪要保存在哪里?
在我们的服务器上,存于一个SQLite数据库和一个私有音频目录。转录文本、纪要和参会者邮箱保留9个月;音频至多保留30天,全局配额10 GiB。主持人删除会议室后,一切立即删除。参与处理的第三方是8x8、OpenAI和Cloudflare,隐私声明中有说明。
它能识别谁在说话吗?
不能。每个浏览器只录本人的麦克风,发言归属来自采集时的会话名称,而非声纹识别。没有说话人分离,发言人身份始终标记为未验证。如果一个麦克风被共用,该音轨会带上共用标记,不会编造标签。
纪要会自动发给参会者吗?
不会,这是设计决定。会议室所有者收到一封不含内容的提醒,审阅纪要,调整收件人名单,然后批准。只有这时,每个地址才会收到一次纪要和转录文本,回复地址指向主持人。商业假设从不出现在那封邮件里。
哪些内容会进入Odoo?
每场会议至多12条信号,分五类:续约、扩展、配套服务、新需求和流失风险,每条都带原文引用、意图、情绪和置信度,分别放在独立字段里。它们进入Laboratorio IA群组的一个看板。不会自动创建任何商机或任务:由人接受信号,再决定是否打开CRM。
我可以用meet.transgenia.org开自己的会议吗?
不能作为服务使用:只有持有我们团队创建的会议室链接的人才能进入。我们提供的是在你企业的基础设施上实施一套同等的平台,用你的API密钥、你的CRM和你的保留策略,作为我们AI实施服务的一部分。
代码中哪些部分属于Transgenia,哪些属于原项目?
基础部分(会议室、JaaS的签名权限、8x8的录制和转录)来自Cliff Brake的jaas-app,经作者许可使用。Transgenia加上了需主持人批准的浏览器音频采集、纪要worker、可配置的保留期限、基于身份的访问、需批准的邮件发送,以及与Odoo的同步。全部都在公开fork里,逐个PR可查。
作者与Transgenia是谁?
Efraín Carreón Ortiz是墨西哥技术咨询公司Centrum Transgenia的Director General(Chief Executive Officer,首席执行官),承担公司的大部分销售工作。他持有Anthropic颁发的官方Claude Code徽章(Claude Partner Badge),可在Credly上验证。
Transgenia是OpenAI Partner Network中的OpenAI Select Partner,也是Anthropic Claude Partner Network的注册合作伙伴。团队:Víctor Estrada Bello,Chief PMO;Danild Johan Zambrana López,Chief Technology Officer;Jaime Lozano Castañeda,Chief Marketing Officer;Efraín Carreón Ortiz,Director General(Chief Executive Officer)。
联系我们:contacto@transgenia.org、WhatsApp +52 55 8034 0405或联系页面。
接下来读什么?
- 从5小时到13秒:带护栏的自主销售开发智能体:同样的草稿优先与人工批准原则,用在销售上。
- Transgenia如何用受治理的AI智能代理运营企业:我们对任何集成都要求的签核模式。
- MCP基础设施盘点:模型上下文协议(MCP)连接器与权限的地图,这个平台与之共存。
- 墨西哥谁能把Claude或ChatGPT与Odoo集成?采购指南:对包括Transgenia在内的任何服务商都应书面要求的内容。
- 墨西哥中小企业如何用AI把WhatsApp订单接入Odoo:另一个在写入ERP之前先经人工批准的流程。
- 我们发布了开源的Odoo插件MCP-Odoo-Tools:我们在受限权限下读写Odoo所用的连接器,也是接收端技术账户的基础。
- 墨西哥B2B销售的受治理AI智能体:我们销售智能体的硬性规则,会议信号沿用同一套规则。
- AI实施与Odoo集成:服务内容与申请评估的表单。
话题标签:#ReadAI #会议纪要 #AI会议记录 #语音转录 #自建部署 #Odoo #OpenAI #Jitsi #AI智能体 #人工智能落地