多年来,开发一个客户要花掉我一个下午。2026年10月12日,我看着一个进程在十三秒内跑完了完整的准备周期,花了两美分半,然后在唯一重要的那一步之前自行停下:发送。这是我们测量到的、为了让这种速度可以被接受而构建的东西,以及我看过之后的想法。

查看 Mermaid 源码
flowchart LR
    A["1. 选定客户
20 至 30 分钟"] --> B["2. 查找邮箱
与决策人
30 至 60 分钟"]
    B --> C["3. 预先电话
15 至 30 分钟"]
    C --> D["4. 撰写邮件
30 至 45 分钟"]
    D --> E["5. 校对与清理
20 至 30 分钟"]
    E --> F["6. 发送并记录
10 分钟"]
    F --> G["7. 规划
后续触达
20 至 30 分钟"]
    G --> T(["估算合计:
每个潜在客户 3 至 5 小时"])
一个人是怎样花五小时开发一个客户的?
Transgenia的大部分销售工作由我承担。试点之前,开发一个新客户要花一整个下午。选定公司并弄清它做什么。查找邮箱和决策人,后者几乎从不公开。打一个预先电话,确认这个人存在而且这个话题与他有关。撰写邮件。校对:删掉形容词,核实每一个数字,加上正确的签名和我们政策要求的两个附件。发送并记录。然后规划后续触达,因为没有跟进的邮件等于扔掉的邮件。
粗略估计,每个潜在客户三到五小时。我特意用“粗略估计”这个词:这是个人估算,不是遥测数据,本文其余部分也都这样对待它。没有人用秒表测过那些下午。我们详细测量过的,是之后发生的事。
那个流程的问题不在于质量。问题在于它只在我有空闲下午的时候才会发生。
九月的遥测数据说了什么?
从2026年中开始,我们就有了一个销售开发智能体。它在代码里叫Valentina,在商务签名里叫Aitana。我们已经在这个博客上讲过我们如何设计它的演示动作和硬性规则。还没讲过的,是当运营依赖一个人启动每一步时发生了什么。
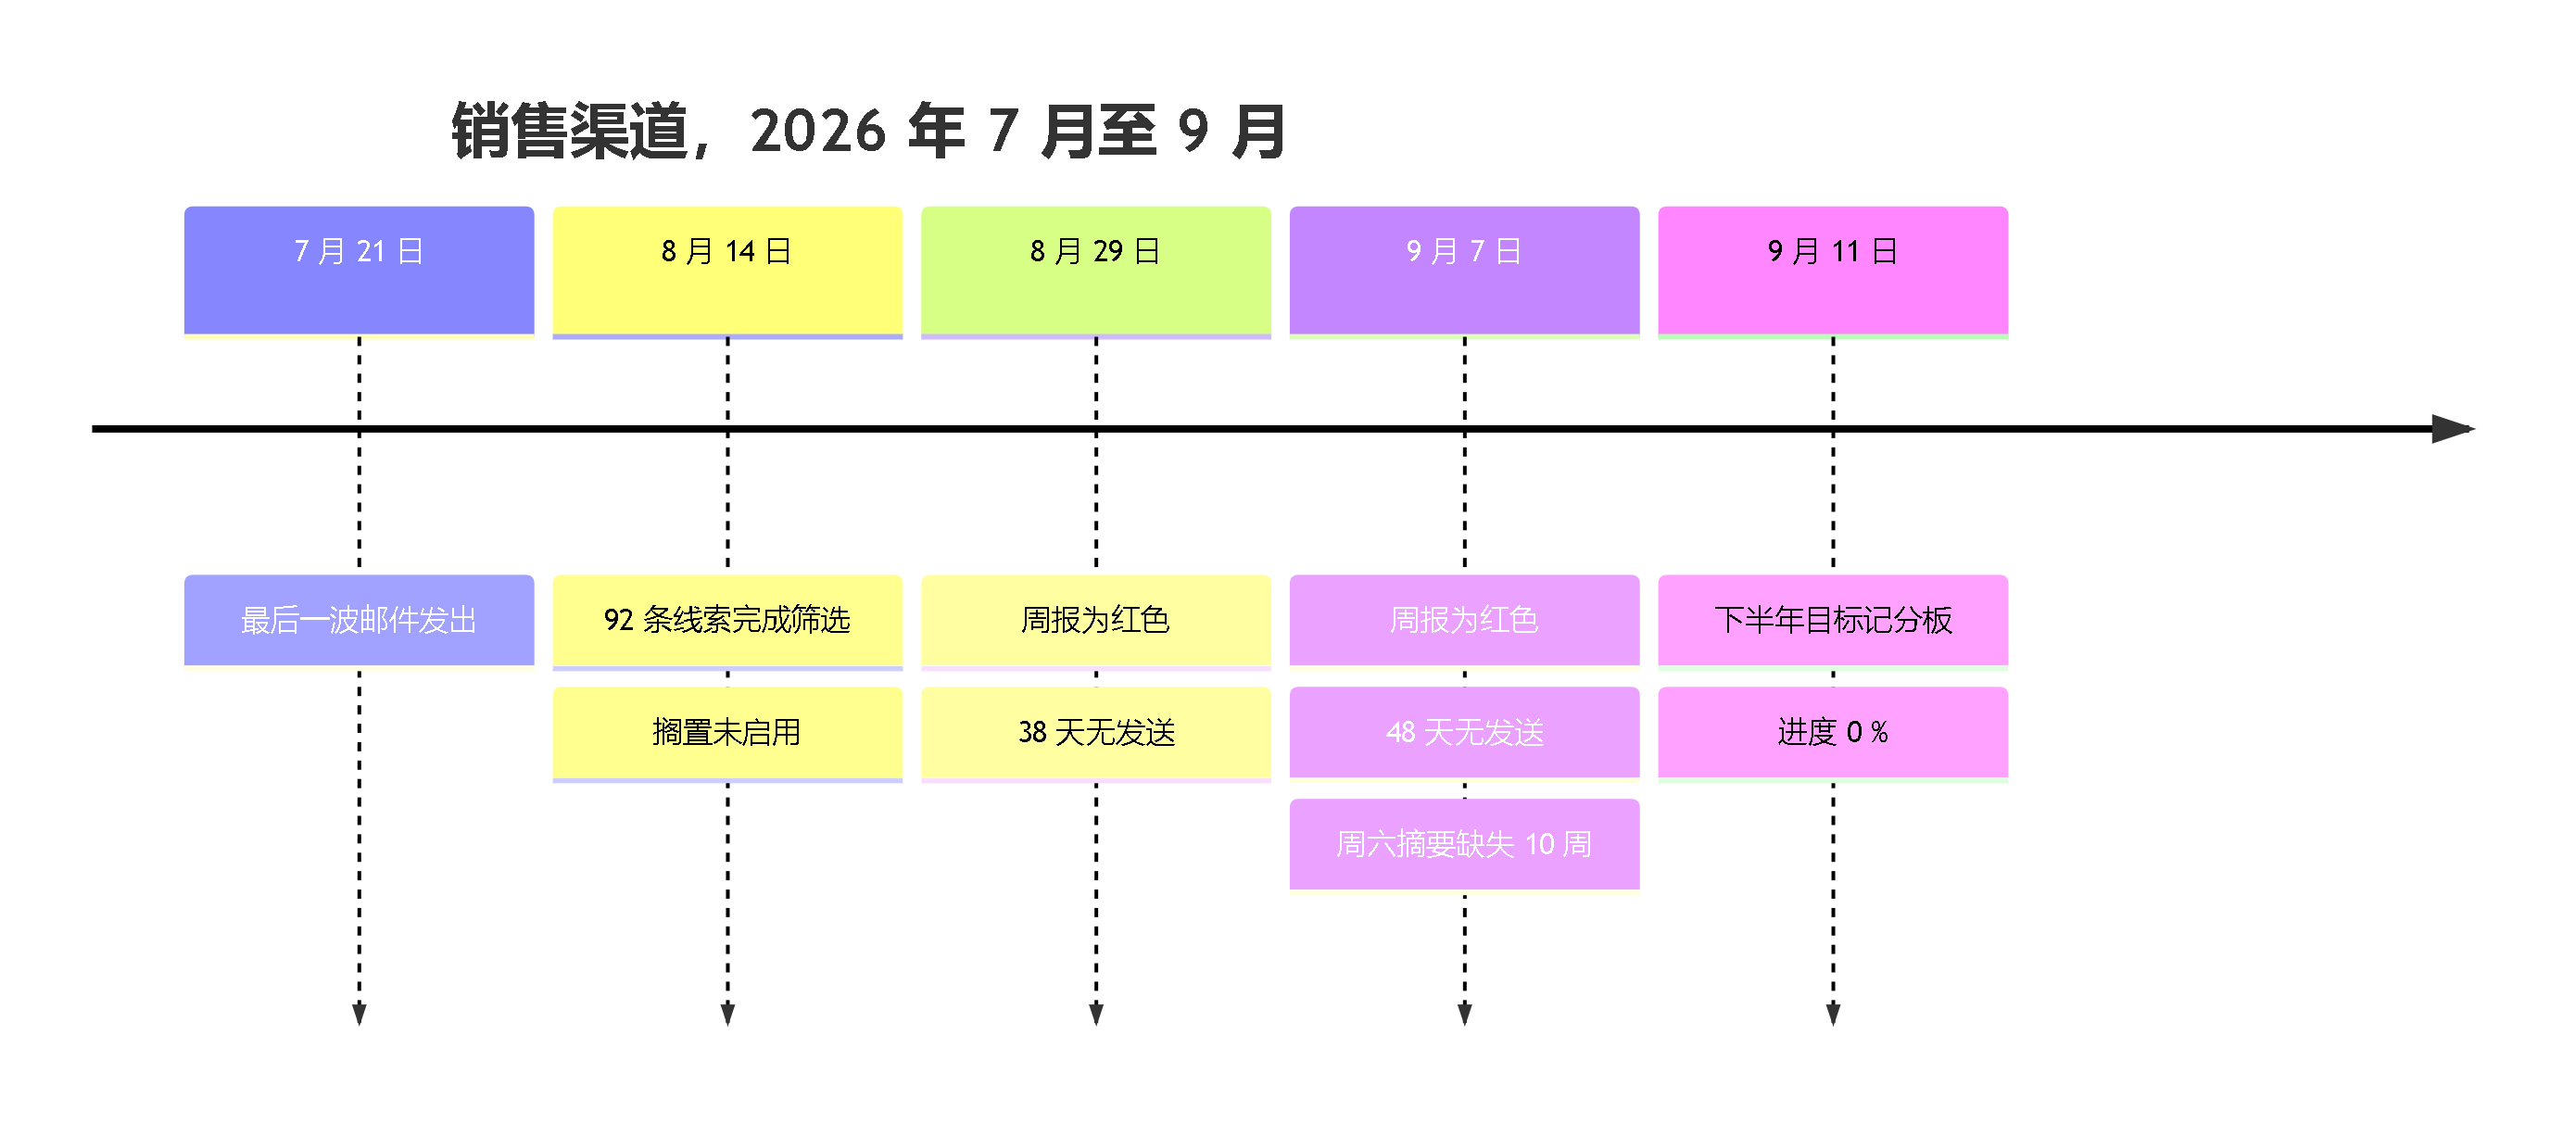
我们的每周复盘日志由一个管理智能体每周六根据系统记录撰写,它在第35周和第36周把销售渠道标为红色。数据是我们自己的,按原样引用:
- 整周零对外发送,连续两周。
- 最后一封邮件发出于7月21日。到9月7日,沉默已达48天。
- 一批经过筛选的92条线索,电话、邮箱和网站都已核实,却搁置了24天没有启用。
- 周六摘要已有十周没有生成。周一摘要因自动化流程中的一个条件被阻塞了六周。
- 半年目标的记分板显示进度为0%,而时间已消耗了38.5%。
查看 Mermaid 源码
timeline
    title 销售渠道,2026 年 7 月至 9 月
    7 月 21 日 : 最后一波邮件发出
    8 月 14 日 : 92 条线索完成筛选 : 搁置未启用
    8 月 29 日 : 周报为红色 : 38 天无发送
    9 月 7 日 : 周报为红色 : 48 天无发送 : 周六摘要缺失 10 周
    9 月 11 日 : 下半年目标记分板 : 进度 0 %
这就是我们自己运营的“最高水平”。模板存在。带抑制名单和每日上限的发送器存在。名单存在。智能体存在。不存在的,是一个能够启动、完成工作、然后停下来,而不需要有人从头到尾陪着的进程。而那个人是我,我正忙着卖东西,于是渠道就停在那里。
应该直说:每一步都需要一个人的智能体不是智能体。它是一张文笔不错的表格。
为什么“打开”智能体还不够?
面对这个诊断,自然的反应是给智能体独自行动的权限。我们拒绝了,原因在于运行时的技术历史。
Valentina在触碰真实邮箱之前经历了七个版本。第一个决定是关于平台的:基于Messages API的自有实现,因为在当时的验证中,托管智能体对我们的组织不可用。然后是一个只用合成数据生成草稿的运行器。然后是一个按消息标识符保证幂等、并对每个人设定五次尝试全局上限的账本。然后是对邮件服务商延迟响应的处理和终态对账。然后是失败即关闭:任何含糊的代码都按失败处理,绝不重试。然后是一个能在重启和两个并发进程下存活的SQLite持久账本。最后是对IMAP邮箱的健康检查,先用219个自动化测试离线验证,再在线上执行了唯一的一次。

查看 Mermaid 源码
flowchart LR
    V0["v0.0
平台决策"] --> V1["v1.0
仅草稿,
合成数据"]
    V1 --> V11["v1.1 与 v1.2
账本与尝试次数
最多五次"]
    V11 --> V13["v1.3
延迟处理与
对账"]
    V13 --> V14["v1.4
失败即关闭"]
    V14 --> V2["v2.0
本地持久账本"]
    V2 --> V3["v3.0-preflight
邮箱健康检查
离线测试"]
    V3 -->|"签核与真实读取
2026 年 10 月 12 日"| N["v3.0-health
真实健康已验证"]
    N -.->|"运营演进,
不是版本发布"| P["使用本地 worker
的运营试点"]
那唯一一次线上读取发生在10月12日墨西哥城时间00:13,使用经证书验证的TLS 1.3,用EXAMINE命令打开文件夹,这在IMAP协议中意味着只读模式,然后登出。记录了四条命令,零次变更,证据连同哈希值一起保存。它没有读取任何一封邮件。
我讲这些,是因为它解释了我们后来对worker的要求标准。如果只是看一眼邮箱而不碰它,就需要219个测试和一句精确措辞的授权,那么向ERP写入所要求的只会更多,不会更少。
平台决策:为什么选择本地、有限的进程?
10月10日,我们对照Anthropic当前的文档重新验证了架构。结论没有听起来那么意识形态化。
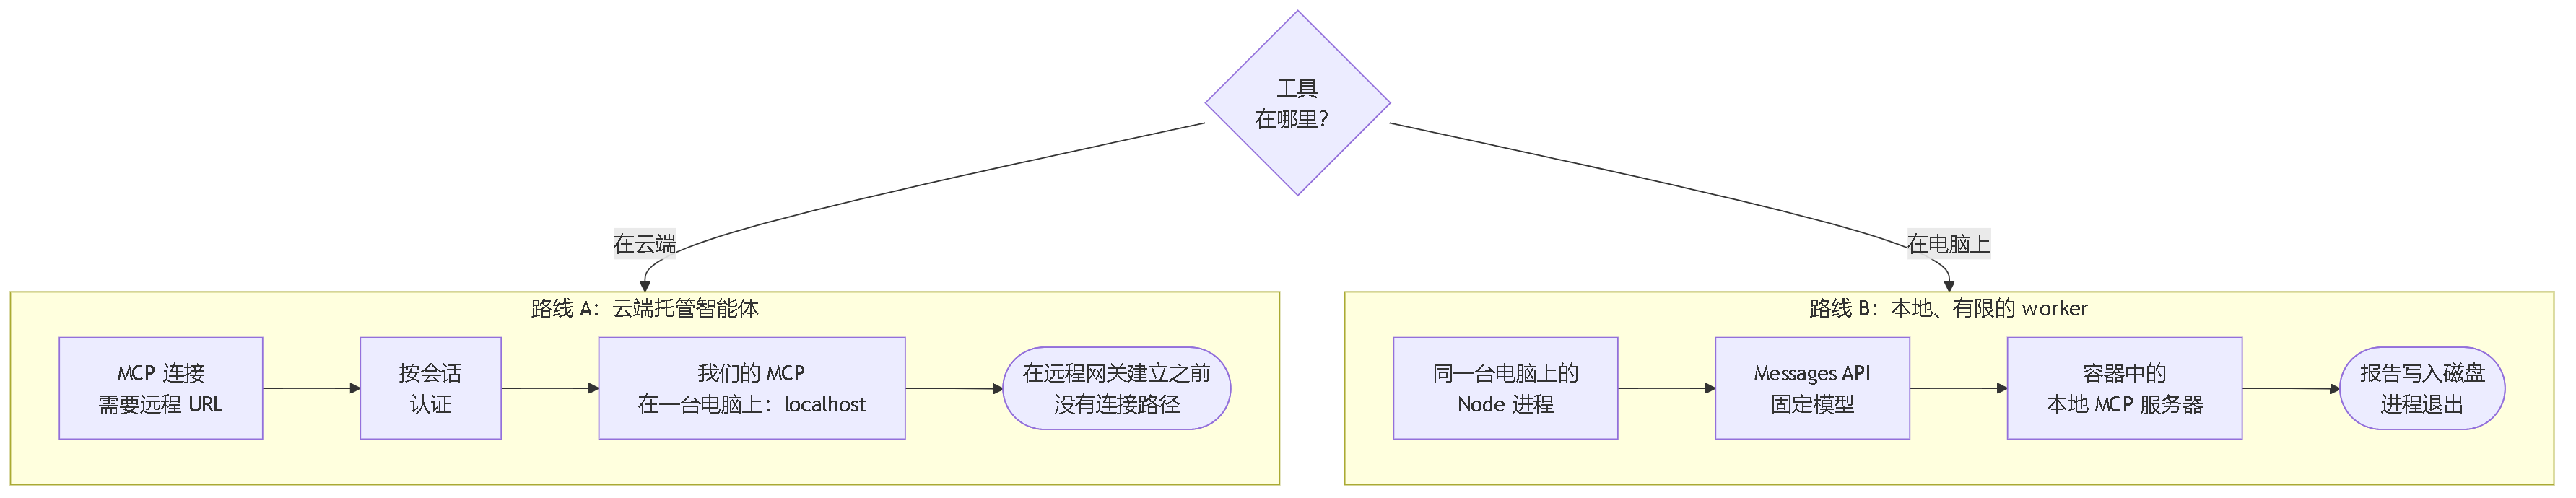
Claude的托管智能体在云端运行、拥有持久会话,它们通过带远程URL的MCP服务器连接工具,并通过凭证保管库进行按会话认证。对于已经发布的基础设施来说,这是正确的设计。我们的工具没有发布:通向ERP的连接器运行在一台台式电脑内的容器里,没有暴露端口。指向localhost的远程连接并不存在。在拥有持久且经过认证的远程网关之前,那条路线不是一条路。
至于桌面扩展,它们是人与智能体协作的好界面,但不是同步桥梁,而且我们也不打算把发送凭证交给它们。
查看 Mermaid 源码
flowchart TB
    subgraph MA["路线 A:云端托管智能体"]
        A1["MCP 连接
需要远程 URL"] --> A2["按会话
认证"]
        A2 --> A3["我们的 MCP
在一台电脑上:localhost"]
        A3 --> A4(["在远程网关建立之前
没有连接路径"])
    end
    subgraph LW["路线 B:本地、有限的 worker"]
        B1["同一台电脑上的
Node 进程"] --> B2["Messages API
固定模型"]
        B2 --> B3["容器中的
本地 MCP 服务器"]
        B3 --> B4(["报告写入磁盘
进程退出"])
    end
    D{"工具
在哪里?"} -->|"在云端"| MA
    D -->|"在电脑上"| LW
我们选择了无聊的方案:一个本地Node进程,不引入新依赖,由人点击启动,用固定模型调用Messages API,使用本地MCP连接器,然后退出。它不是常驻服务。它不会被安装成计划任务。它不开端口。如果电脑关着,什么都不会发生,这一点也作为限制被记录在案。
一个能自行结束的周期是什么样的?
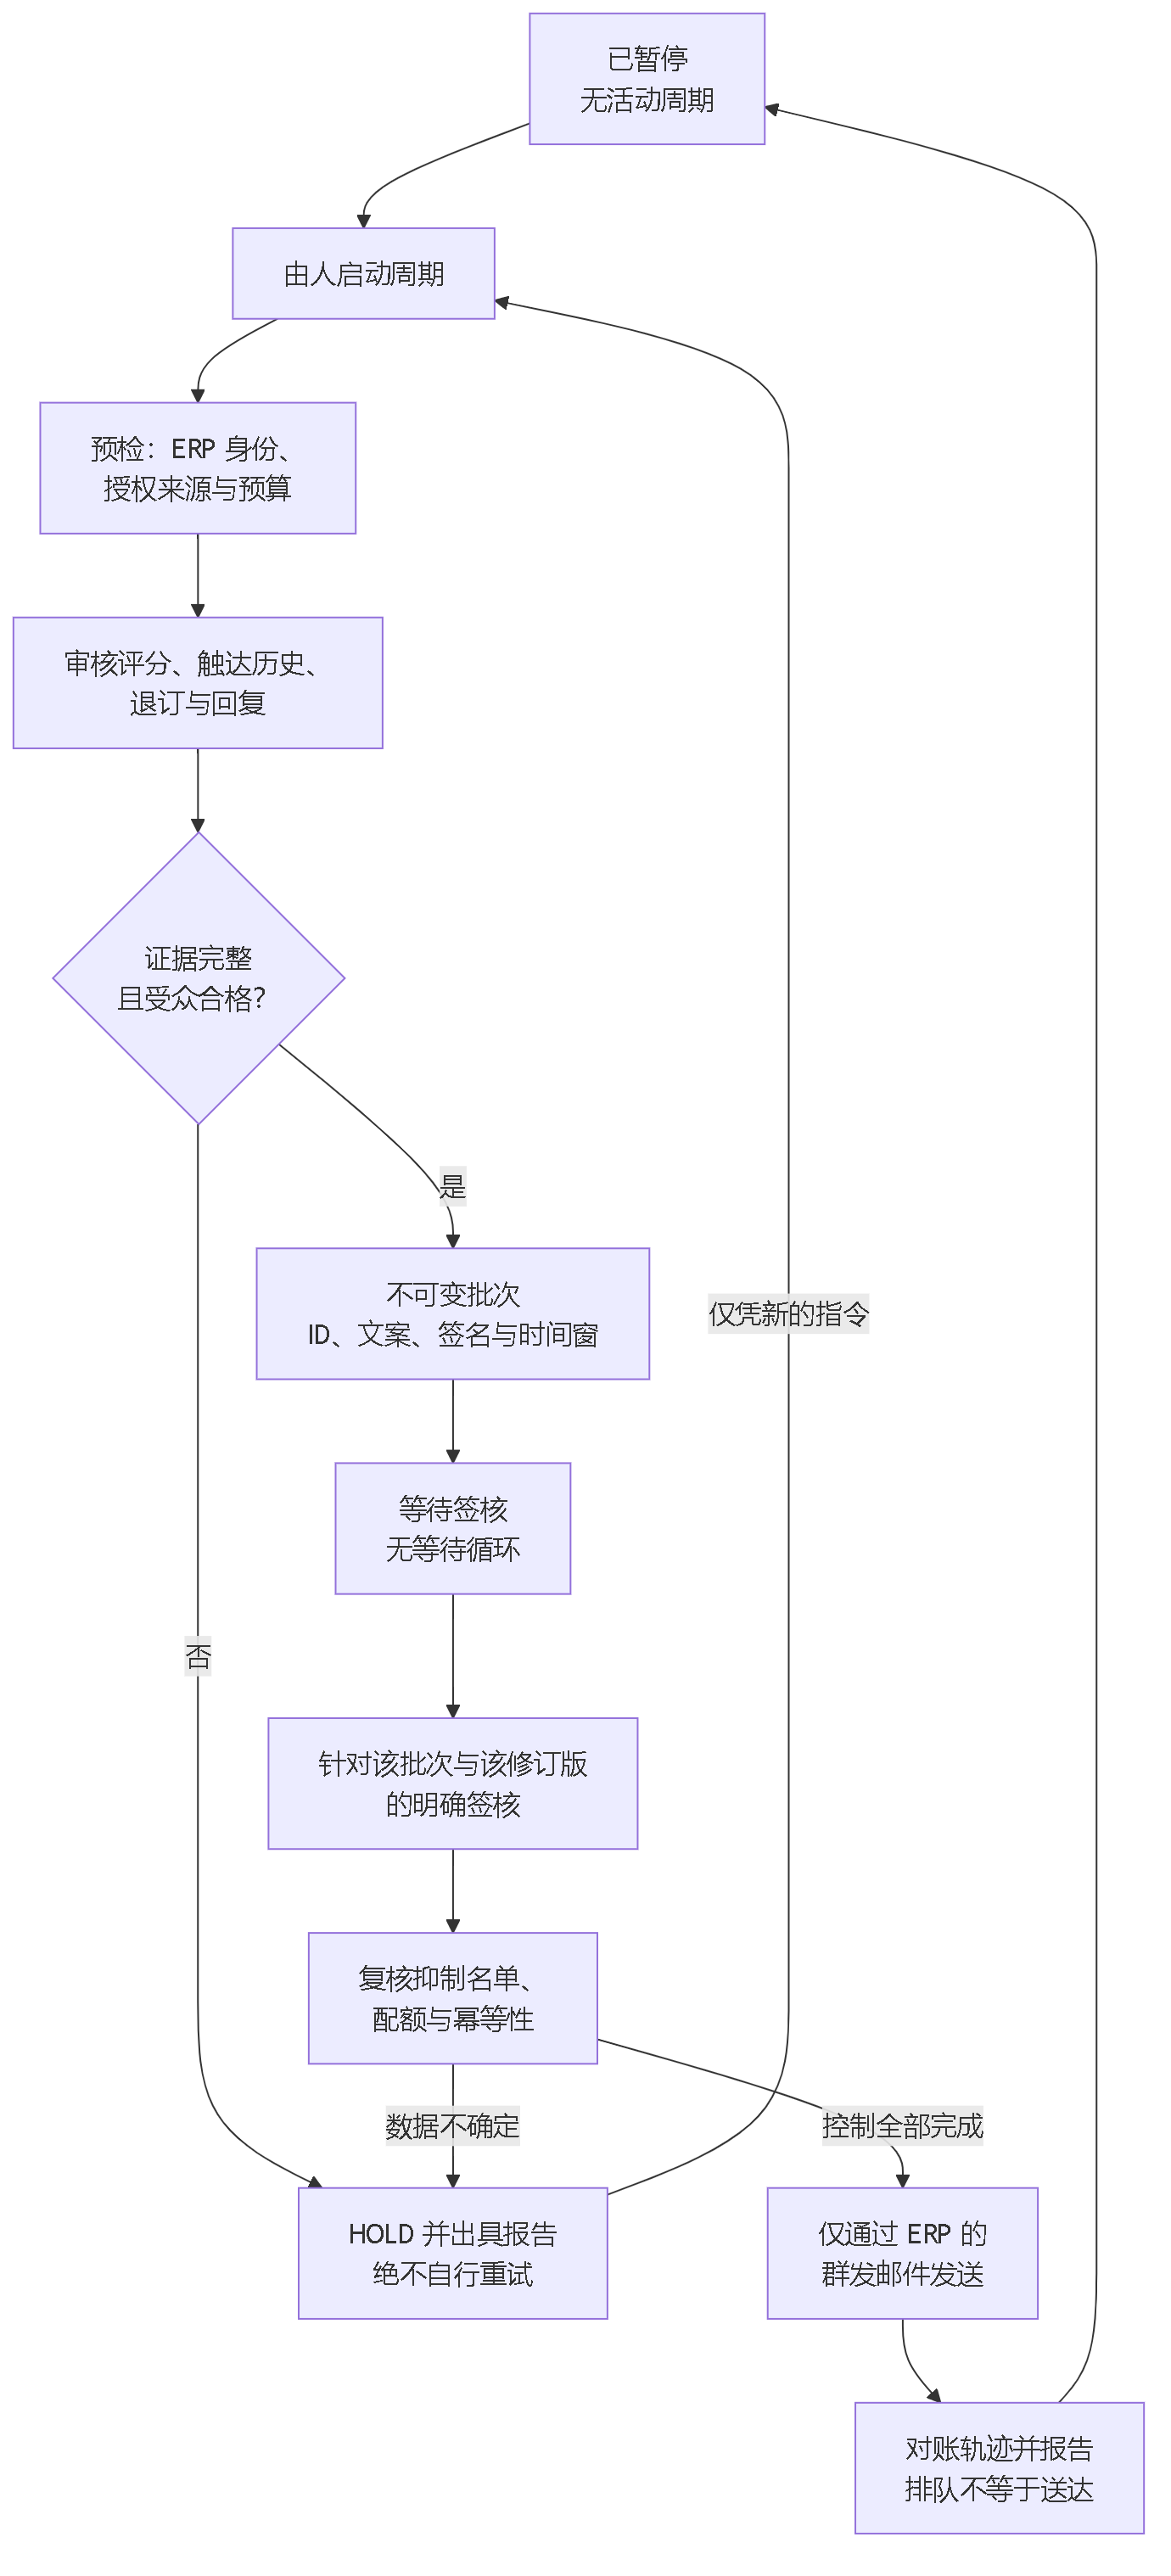
周期的契约先于代码写成,我们在实现之前就把它画了出来。由人启动。worker核验ERP身份、授权的凭证来源和预算。审核评分、触达历史、退订与回复。如果证据不足或没有合格受众,就以带报告的HOLD结束,而HOLD绝不自行重试。如果有受众,就冻结一个不可变批次并等待人工签核,没有等待循环:进程直接退出,把批次准备好。发送一旦发生,只通过ERP的群发邮件模块进行,绝不通过智能体自己的SMTP。
查看 Mermaid 源码
flowchart TD
    START["已暂停
无活动周期"] --> RUN["由人启动周期"]
    RUN --> PREF["预检:ERP 身份、
授权来源与预算"]
    PREF --> CHECK["审核评分、触达历史、
退订与回复"]
    CHECK --> OK{"证据完整
且受众合格?"}
    OK -- 否 --> HOLD["HOLD 并出具报告
绝不自行重试"]
    HOLD -->|"仅凭新的指令"| RUN
    OK -- 是 --> LOT["不可变批次
ID、文案、签名与时间窗"]
    LOT --> WAIT["等待签核
无等待循环"]
    WAIT --> AP["针对该批次与该修订版
的明确签核"]
    AP --> RECHECK["复核抑制名单、
配额与幂等性"]
    RECHECK -->|"数据不确定"| HOLD
    RECHECK -->|"控制全部完成"| MAIL["仅通过 ERP 的
群发邮件发送"]
    MAIL --> REPORT["对账轨迹并报告
排队不等于送达"]
    REPORT --> START
10月12日,我们运行了两次真实周期和第三次空周期。
第一次是只读的:两次推理、两次对ERP的计数调用、一份写入磁盘的报告,然后进程退出。从预算预留到结算经过了15秒。计算得出的花费:0.018美元。
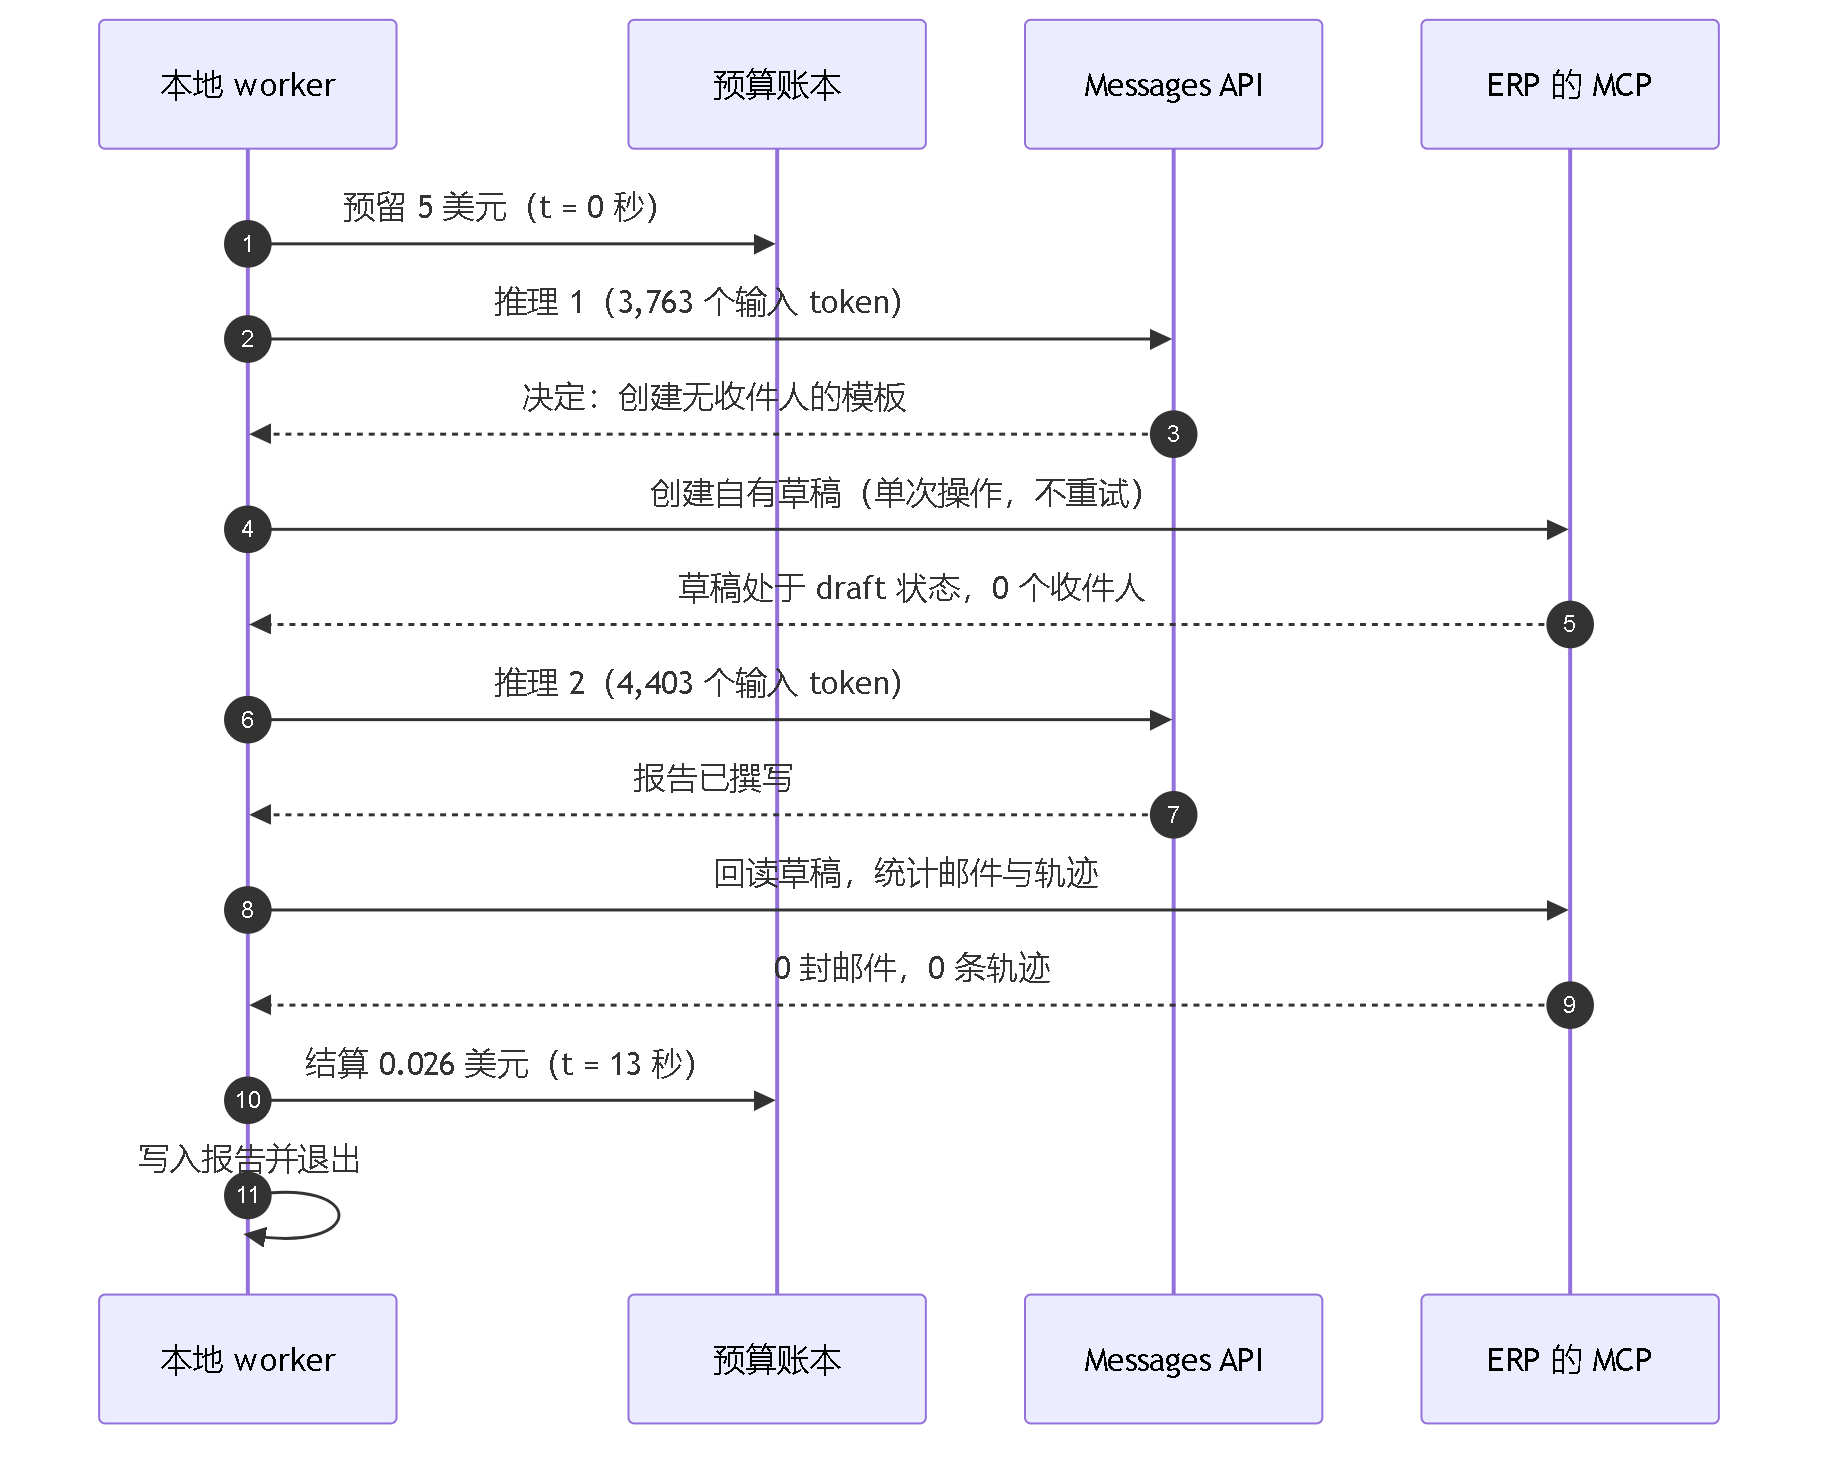
第二次才是关键。在获得单次写入的明确授权后,worker创建了一份没有收件人的群发邮件模板,主题行用大写字母写明不得发送,然后回读它,统计关联的邮件和轨迹,结果是零和零。两次推理、一次写入、从预留到结算13秒。计算得出的花费:0.026美元。
查看 Mermaid 源码
sequenceDiagram
    autonumber
    participant W as 本地 worker
    participant L as 预算账本
    participant API as Messages API
    participant MCP as ERP 的 MCP
    W->>L: 预留 5 美元(t = 0 秒)
    W->>API: 推理 1(3,763 个输入 token)
    API-->>W: 决定:创建无收件人的模板
    W->>MCP: 创建自有草稿(单次操作,不重试)
    MCP-->>W: 草稿处于 draft 状态,0 个收件人
    W->>API: 推理 2(4,403 个输入 token)
    API-->>W: 报告已撰写
    W->>MCP: 回读草稿,统计邮件与轨迹
    MCP-->>W: 0 封邮件,0 条轨迹
    W->>L: 结算 0.026 美元(t = 13 秒)
    W->>W: 写入报告并退出
第三次启动最让我安心。我们把它作为每日周期运行:worker在应用了抑制名单、五次触达历史和上一批次的排除项之后寻找新候选人,一个也没找到,于是在没有做任何推理、没有创建模板、零花费的情况下退出。同一天的第二次点击返回了先前的结果,重放标志置位,账本哈希保持不变。
两次带推理的周期合计:授权的20美元试点中花了0.045美元。
哪些护栏让这种速度可以被接受?
我想分享的部分不是速度。而是我们在打开进程之前决定好的那张清单,因为正是它们让十三秒不至于成为十三秒的风险。
预算在思考之前就已预留。 每个周期在第一次推理之前,先向持久账本写入5美元的预留。如果预留超出试点上限,进程就不会启动。退出时,按API报告的token用量和模型的公开费率计算消耗并结算。如果结果不确定,就保留全部预留并阻止下一个周期,直到有人完成对账。内部限制是明确的:最多八轮模型调用、二十次连接器调用、2,048个输出token、120秒超时,并且没有自动重试。模型被固定,没有静默回退:价格或模型一旦变化,必须有人手动修改。
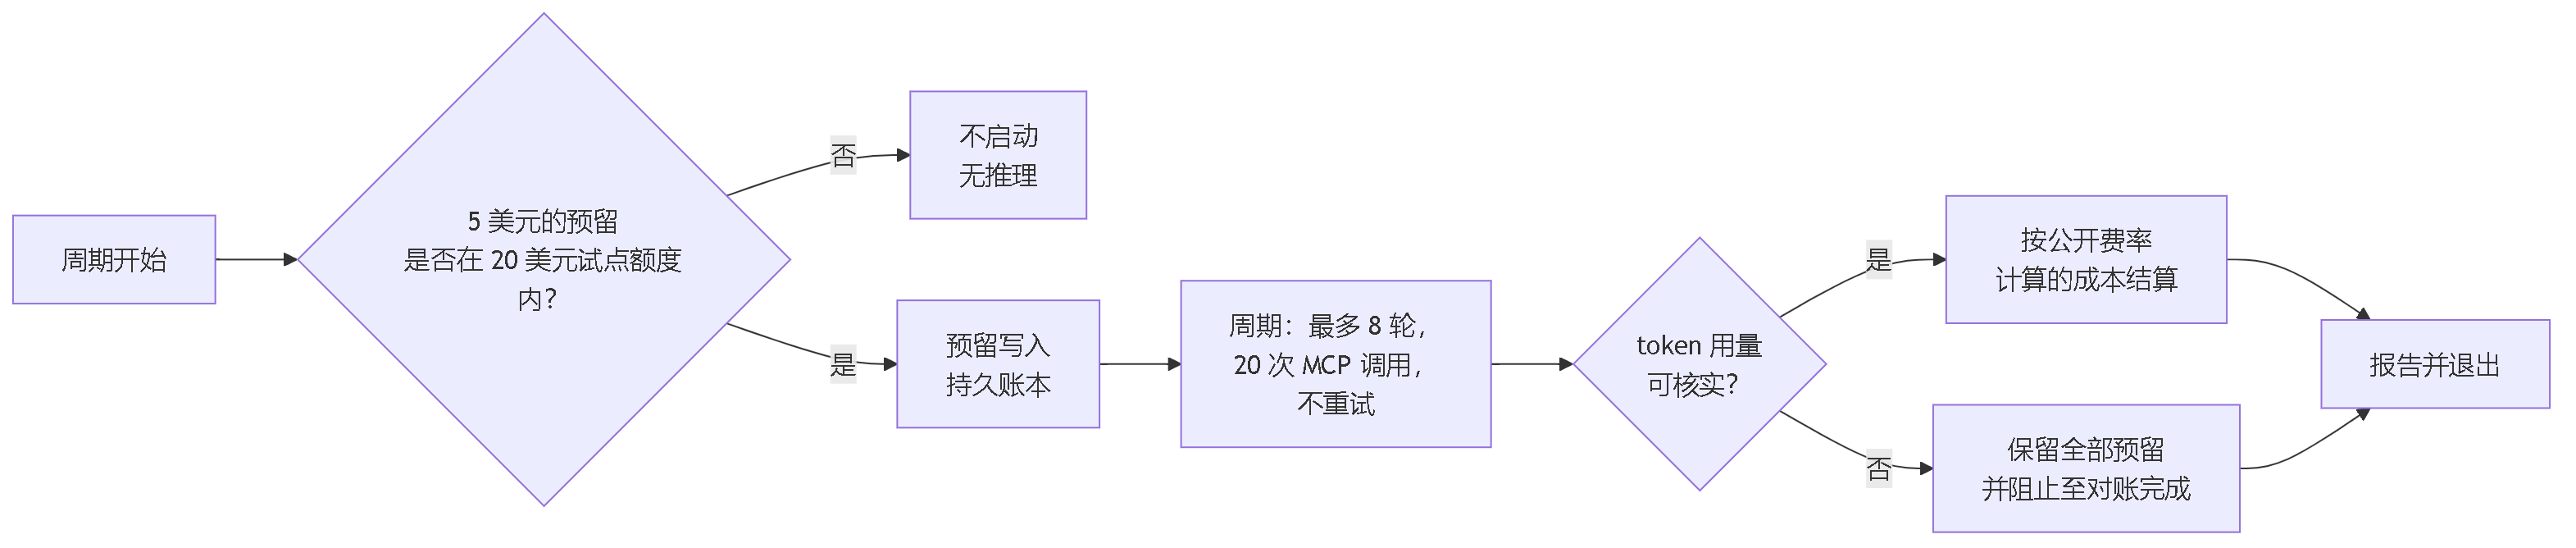
查看 Mermaid 源码
flowchart LR
    S["周期开始"] --> R{"5 美元的预留
是否在 20 美元试点额度内?"}
    R -- 否 --> STOP["不启动
无推理"]
    R -- 是 --> RES["预留写入
持久账本"]
    RES --> RUN["周期:最多 8 轮,
20 次 MCP 调用,
不重试"]
    RUN --> U{"token 用量
可核实?"}
    U -- 是 --> SET["按公开费率
计算的成本结算"]
    U -- 否 --> KEEP["保留全部预留
并阻止至对账完成"]
    SET --> END["报告并退出"]
    KEEP --> END
每天一个周期,一次只有一个进程。 本地锁防止两个周期同时运行。本地日期决定是否已经有过周期;第二次启动返回先前结果而不花费。没有新候选人的日子以无推理、无空草稿结束,因为例行创建的空草稿在ERP里同样是噪音。
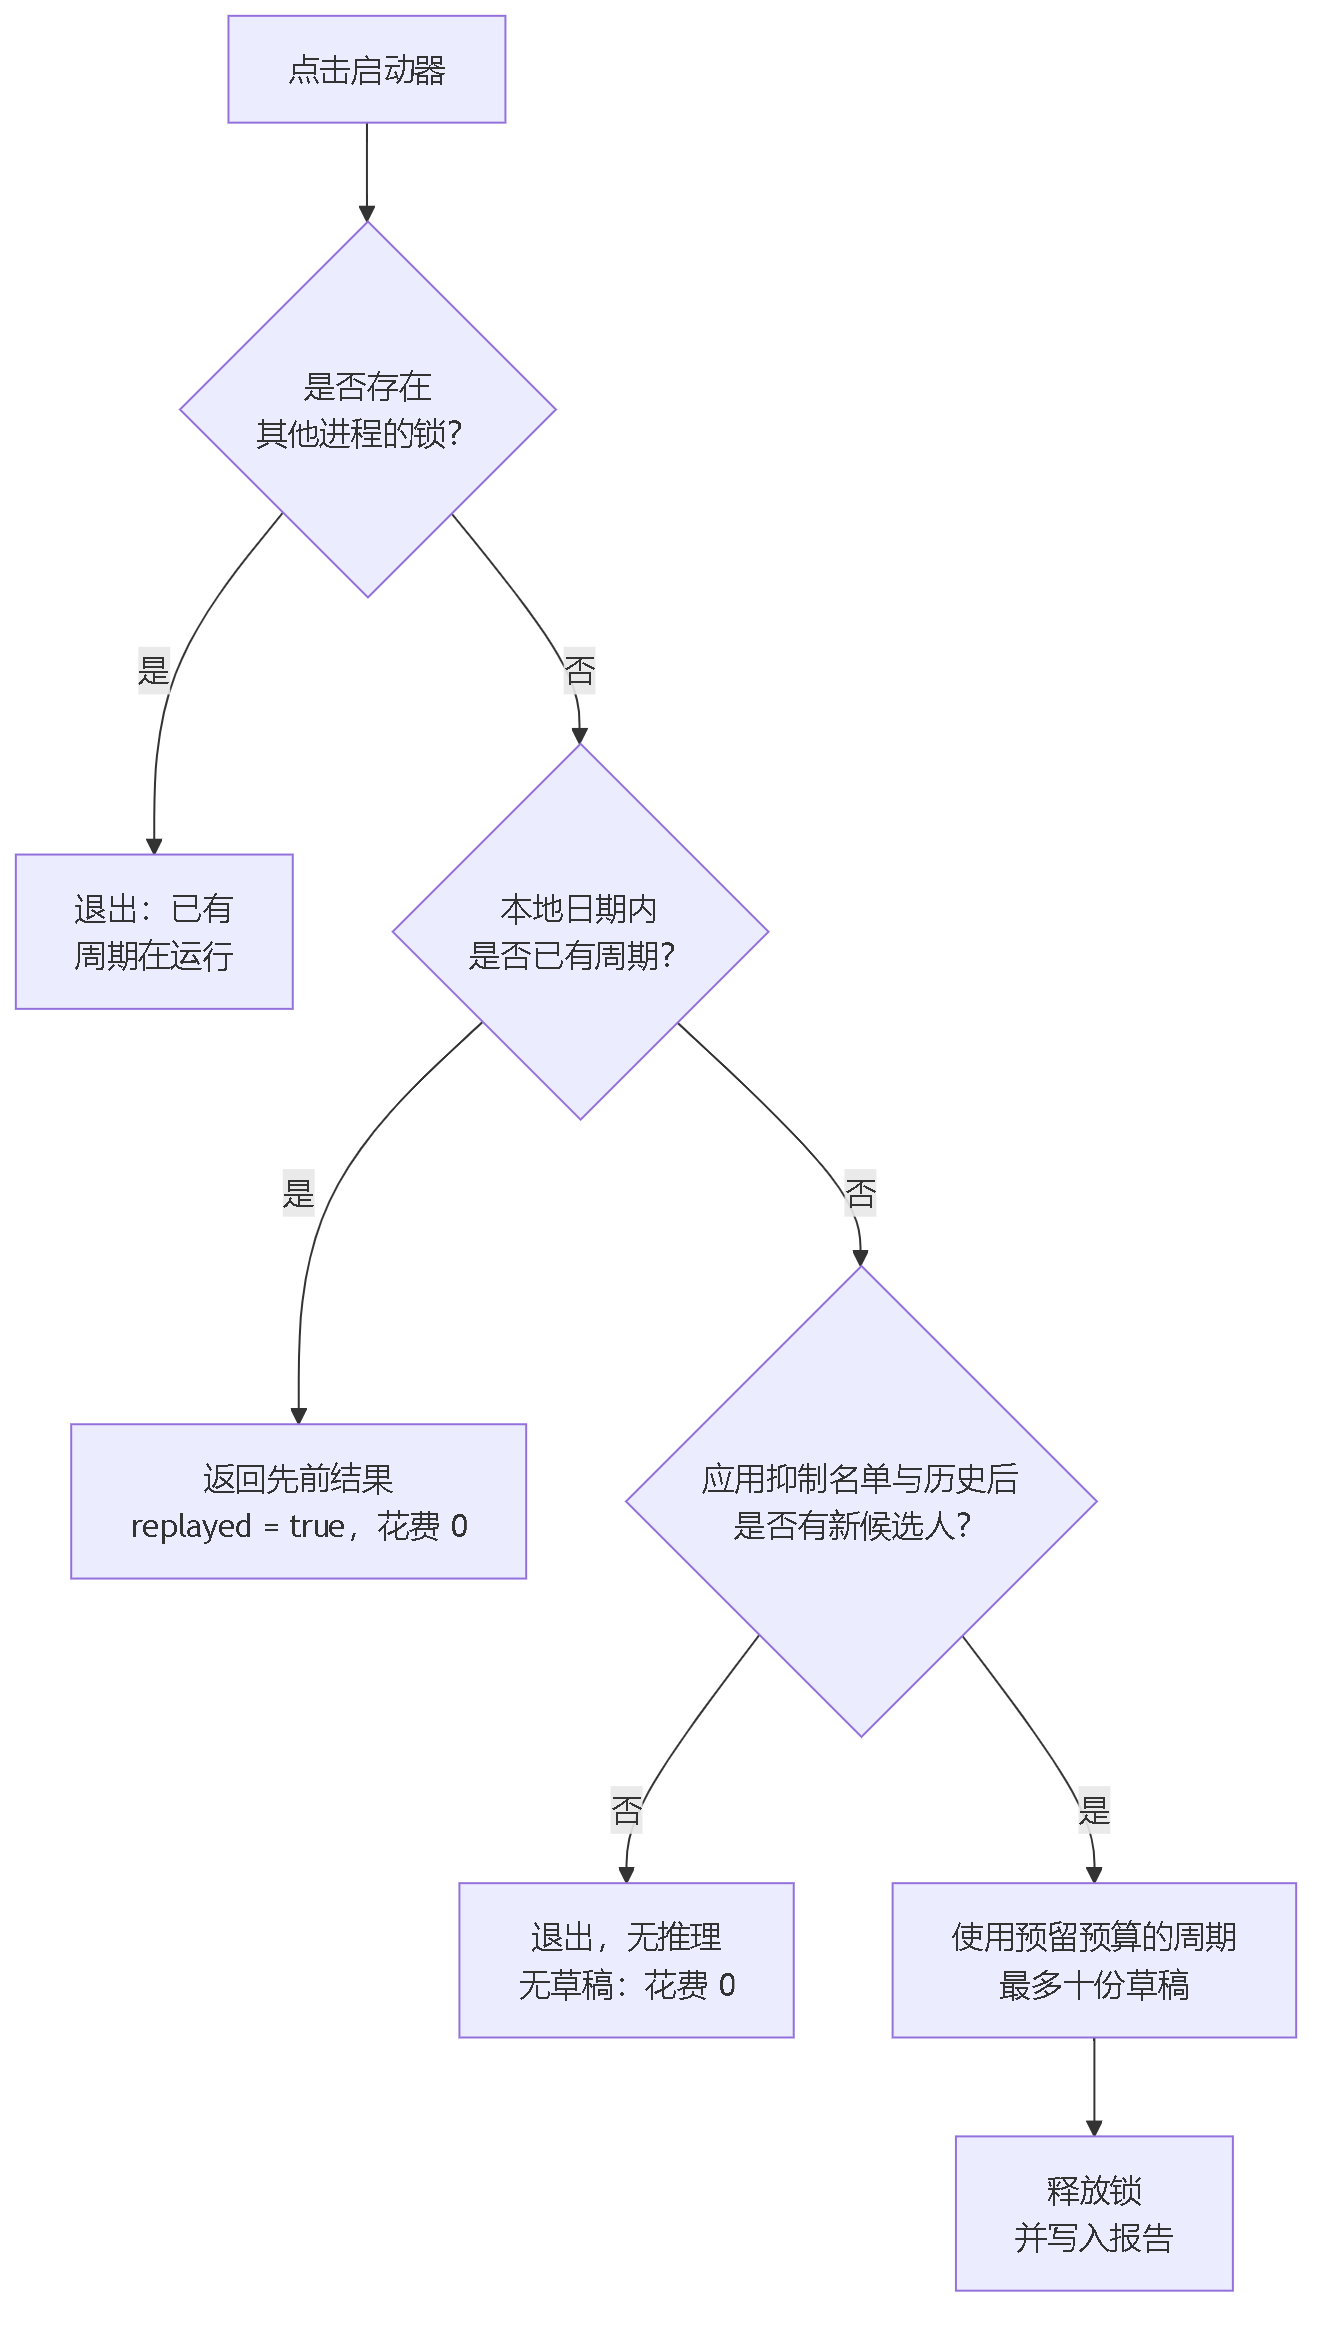
查看 Mermaid 源码
flowchart TD
    C["点击启动器"] --> LOCK{"是否存在
其他进程的锁?"}
    LOCK -- 是 --> X1["退出:已有
周期在运行"]
    LOCK -- 否 --> DAY{"本地日期内
是否已有周期?"}
    DAY -- 是 --> X2["返回先前结果
replayed = true,花费 0"]
    DAY -- 否 --> CAND{"应用抑制名单与历史后
是否有新候选人?"}
    CAND -- 否 --> X3["退出,无推理
无草稿:花费 0"]
    CAND -- 是 --> RUN["使用预留预算的周期
最多十份草稿"]
    RUN --> REL["释放锁
并写入报告"]
连接器没有发送按钮。 专用的MCP服务器暴露六个读取工具和两个草稿工具:仅创建和编辑本周期自己创建的草稿,收件人上限为十个。没有发送、定时、删除或修改联系人的工具。这不是写在文档里、智能体可以忽略的政策:这是代码中的一处缺席。发送由人在审核批次之后在ERP中完成。
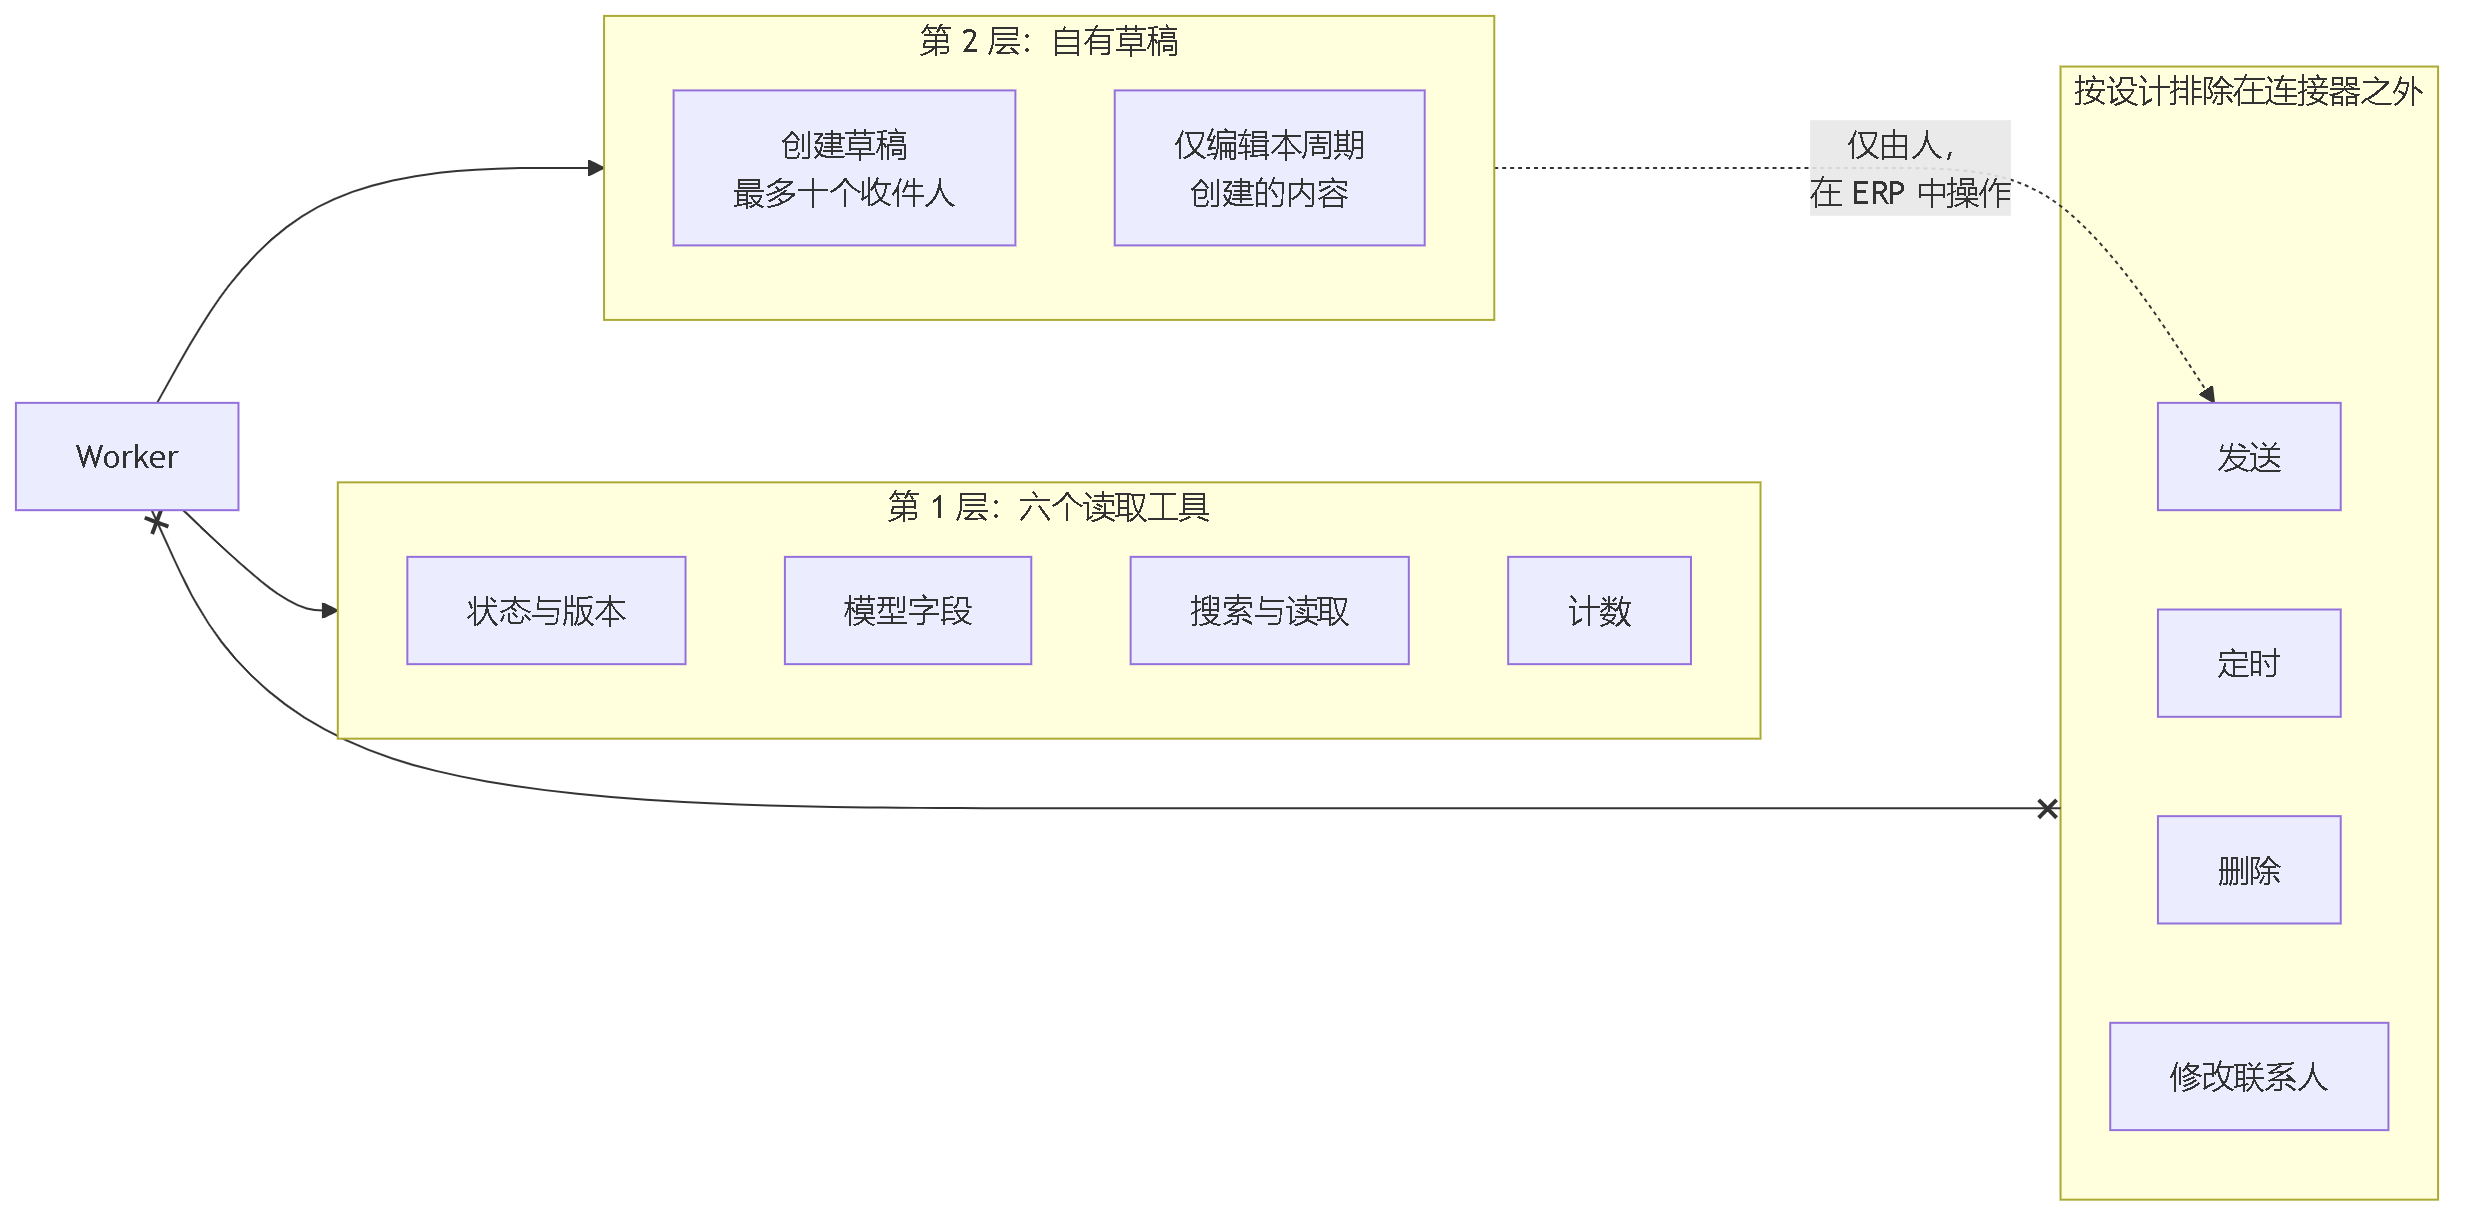
查看 Mermaid 源码
flowchart LR
    subgraph READ["第 1 层:六个读取工具"]
        R1["状态与版本"]
        R2["模型字段"]
        R3["搜索与读取"]
        R4["计数"]
    end
    subgraph DRAFT["第 2 层:自有草稿"]
        D1["创建草稿
最多十个收件人"]
        D2["仅编辑本周期
创建的内容"]
    end
    subgraph NO["按设计排除在连接器之外"]
        N1["发送"]
        N2["定时"]
        N3["删除"]
        N4["修改联系人"]
    end
    W["Worker"] --> READ
    W --> DRAFT
    DRAFT -.->|"仅由人,
在 ERP 中操作"| N1
    W x--x NO
每项断言都有回读。 worker不会报告“我创建了草稿”。它回读记录,核实其处于草稿状态,统计关联的邮件与轨迹,并把那些零写进报告。我们在认可周期之前用独立查询重复这些读取。智能体的报告在有人核对之前只是一个假设。
商业规则也是代码。 每个人最多五次触达,跨活动与渠道计算。每天一个逻辑批次。文案简短、有证据、不编造数字。已经是商机或客户的线索不进入冷开发。这些规则原本以文本形式存在于我们的技能中;现在其中一部分写进了每次写入前运行的守卫,它在无法核实历史时会失败即关闭。
试点证明了什么,没有证明什么?
写这篇文章之前,我们强迫自己做出这个区分,因为技术能力与商业结果太容易被混淆。

查看 Mermaid 源码
flowchart LR
    subgraph SI["试点证明了的"]
        S1["用受限工具
读取 ERP 并计数"]
        S2["决策并写入
自有草稿"]
        S3["回读自己的写入
并核实 0 封邮件、0 条轨迹"]
        S4["在上限内
预留、花费与结算"]
        S5["没有候选人时
自行停止,零花费"]
    end
    subgraph NO["试点没有证明的"]
        N1["合格且获批的
新受众"]
        N2["向潜在客户的
真实发送"]
        N3["电脑关机或
在远程服务器上运行"]
        N4["接收并分类
回复"]
        N5["模型密钥
有全局限额"]
    end
    SI ~~~ NO
它证明了一个自主进程可以用受限工具读取ERP、做出决定、写入自己的草稿、回读自己的写入、预留并结算预算,并在没有工作时自行停止。所有这些都有证据:清单、账本、回读和自动化测试,运行时219个,worker 13个。
它没有证明一个新的、获批的商业受众:那天数据库在不放宽标准的情况下没有合格候选人,而我们没有放宽标准。它没有证明向潜在客户的真实发送;根本没有发送。它没有证明在电脑关机或远程服务器上运行。它没有证明接收和分类回复;邮箱健康检查不是摄取。它也没有证明模型密钥有全局花费上限:账本限制的是这个worker,而不是使用同一密钥的其他程序。
由机器创建的空草稿是技术能力的证明。它不是合格的批次,我们也不把它当成合格批次来呈现。
小时对秒:这个比较诚实吗?
我想对标题里的数字格外谨慎,因为它会被重复得最多。
三到五小时是每个潜在客户从头到尾的个人估算,包括电话和后续触达的规划。13秒和15秒是每个周期的遥测数据,根据预算账本和逐请求用量日志重建。一个周期不包括预先电话,也不包括发送的决定,而且在这些测试中也不包括真实受众。我们没有拿同类与同类比较,宁愿自己说出来,也不愿让细心的读者发现。
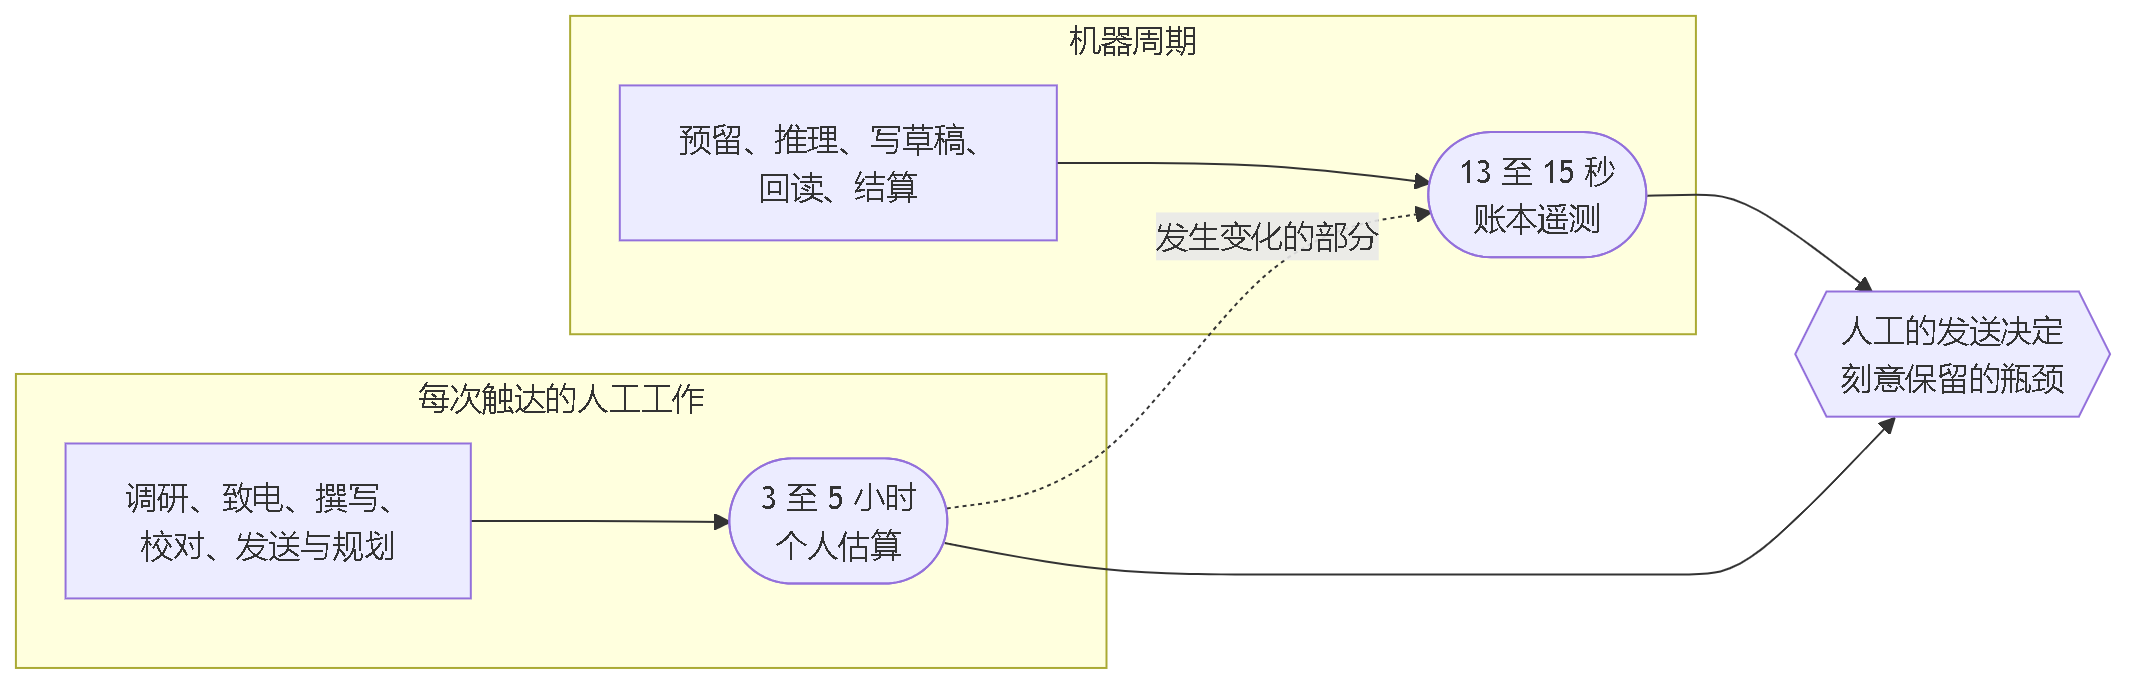
查看 Mermaid 源码
flowchart LR
    subgraph H["每次触达的人工工作"]
        H1["调研、致电、撰写、
校对、发送与规划"]
        H2(["3 至 5 小时
个人估算"])
        H1 --> H2
    end
    subgraph M["机器周期"]
        M1["预留、推理、写草稿、
回读、结算"]
        M2(["13 至 15 秒
账本遥测"])
        M1 --> M2
    end
    H2 -.->|"发生变化的部分"| M2
    M2 --> V{{"人工的发送决定
刻意保留的瓶颈"}}
    H2 --> V
真正改变的,是瓶颈所在的位置。以前瓶颈是我的下午。现在瓶颈是一个决定:审核一个冻结的批次并签核。这个决定花几分钟而不是几小时,而且它是我们唯一想保留的,因为它是唯一不可逆的。
看到第二次周期的报告时,我产生了一种在一个文本文件面前没料到会有的感觉。我感到害怕。不是因为进程做了什么错事,而是因为它把一件正确的事做得比我能观察到的更快。这种感觉催生了最后一节。
Transgenia(特兰斯赫尼亚)的立场是什么?
这篇文章并不中立,这一点值得说明。我们的立场如下,供你与任何其他服务商对照:
- 必须尊重人工智能。 不是畏惧,也不是崇拜:是运营意义上的尊重,是对任何行动快于我们监督能力的系统应有的尊重。试点的结果配得上这种尊重,而面对它们带来的惊吓,成熟的回应是工程,不是热情。
- 界限在开启之前写好,而不是在第一次事故之后。 预留预算、每天一个周期、锁、收件人上限和发送工具的缺席都是事先的决定。在错误之后才加上的护栏,已经付出了那个错误的代价。
- 每一步都需要一个人的智能体不是智能体。 48天的沉默教会了我们这一点。正确的自主性是独自完成所有可逆的事,并在不可逆的事情面前停下。
- 不可逆的事由一个有名有姓的人决定。 在Transgenia,每个批次的签核由总经理签字。不是委员会,也不是概率规则:是一个看着批次并为它负责的人。
- 智能体的报告是一个假设。 worker的每项断言在被接受之前都要对照独立读取进行核对。如果我们无法核实,就标为未证明,正如上文所做的那样。
- 没有证据的速度一文不值。 十三秒之所以是一个有趣的数字,只因为账本、清单和回读存在。没有它们,那就是十三秒的信仰。
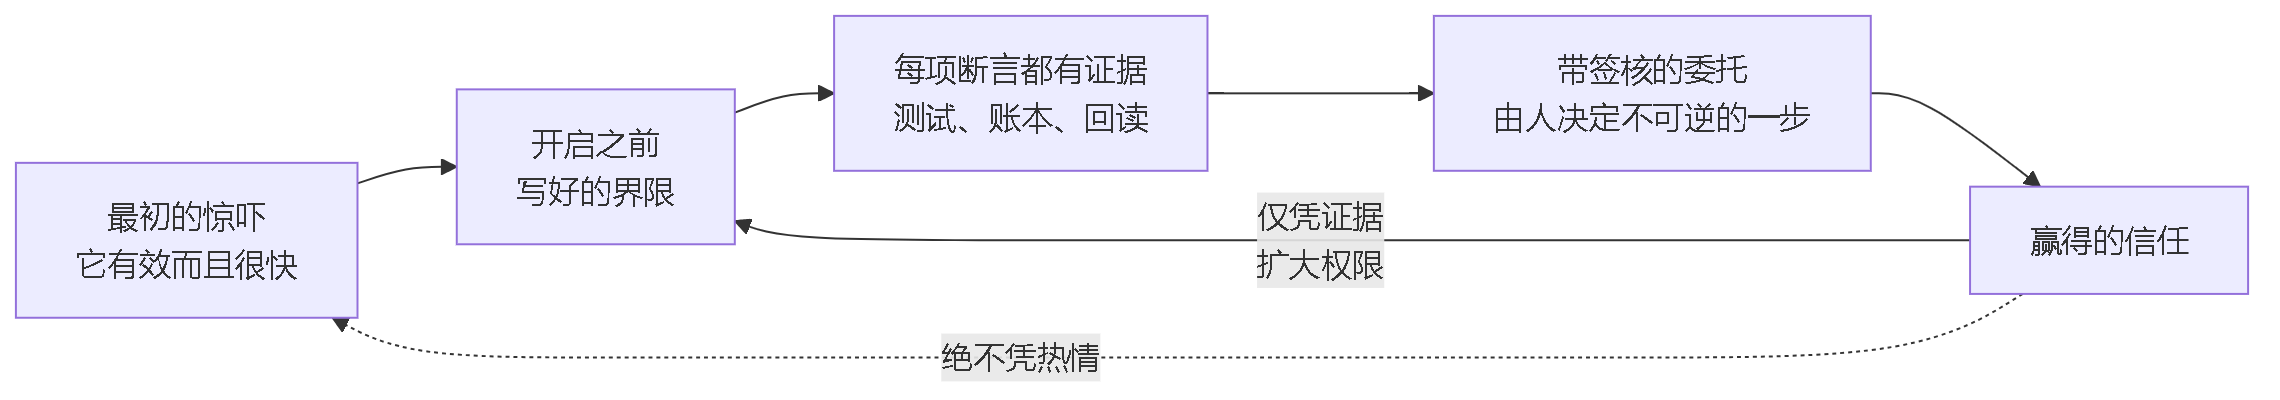
查看 Mermaid 源码
flowchart LR
    F["最初的惊吓
它有效而且很快"] --> G["开启之前
写好的界限"]
    G --> E["每项断言都有证据
测试、账本、回读"]
    E --> D["带签核的委托
由人决定不可逆的一步"]
    D --> C["赢得的信任"]
    C -->|"仅凭证据
扩大权限"| G
    C -.->|"绝不凭热情"| F
本文引用了哪些资料?
关于产品和协议的技术事实依据公开来源。试点和销售渠道的数字属于Transgenia:来自我们2026年10月10日至12日的内部审计日志以及8月和9月的每周复盘,并已如此标注。
- Anthropic,Messages API参考:本地worker进行推理所用的API,每个请求有输出token上限。
- Anthropic,Claude Sonnet 5.5:worker中固定使用的模型。
- Anthropic,模型公开定价:Sonnet 5.5每百万输入token 2美元、每百万输出token 10美元,账本据此计算花费。
- Anthropic,Managed Agents及其MCP连接器:托管智能体通过带远程URL和按会话认证的MCP服务器连接工具;这是平台决策的依据。
- Model Context Protocol:通向ERP的连接器所依据的开放标准。
- RFC 9051,IMAP4rev2:EXAMINE命令以只读模式打开邮箱,正如运行时的健康检查所做的那样。
- RFC 8446,TLS 1.3:那次读取所使用的协议。
- SQLite,原子事务:运行时持久账本的引擎;其事务即使在断电时也保持原子性和持久性。
- Transgenia,面向墨西哥B2B销售的受治理AI代理:本试点继承的演示动作与硬性规则。
- Transgenia,我们如何用受治理的AI智能代理运营:草稿优先与签核模式。
- Transgenia,试点遥测数据(2026年10月12日的周期、预算账本、清单与回读)以及销售渠道每周复盘(2026年第35周与第36周):公司内部记录,引用时不含记录标识符或联系人数据。
常见问题
智能体会自己发邮件吗?
不会。worker使用的连接器没有发送、定时或删除工具。它可以读取ERP,并创建或编辑自己的草稿,收件人上限为十个。发送由人在ERP的群发邮件模块中完成,前提是审核了批次并给出明确签核。
“13秒”到底指什么?
指worker第二次真实周期中从预算预留到结算的时间,根据账本和逐请求用量日志重建。它包括两次推理、一次草稿写入和核实读取。它不包括预先电话、人工审核或发送的决定。
三到五小时是从哪里来的?
这是作者对一个客户完整人工销售开发流程的个人估算:调研、查找邮箱、致电、撰写、校对、发送和规划后续触达。它不是遥测数据,文章每次使用时都会说明。
试点花了多少钱?
两次带推理的周期合计0.045美元,按API报告的token用量和Sonnet 5.5的公开费率计算,来自授权的20美元试点,每周期上限5美元。第三次周期没有新候选人,花费为零。这不是发票,也不是对账户余额的核实。
为什么不用云端的托管智能体?
因为托管智能体通过带远程URL和按会话认证的MCP服务器连接工具,而我们通向ERP的连接器运行在没有暴露端口的本地容器中。没有持久且经过认证的远程网关,那条路线就不存在。我们选择了一个由人点击启动、自行结束的本地有限进程。
如果worker在周期中途失败会怎样?
设计是失败即关闭。如果结果不确定,账本保留全部预算预留并阻止下一个周期,直到有人完成对账。没有自动重试,也没有模型回退。因崩溃而遗留的锁需要先确认没有活动进程,再手动恢复。
电脑关机时这套系统能运行吗?
不能。worker需要电脑、Node和连接器的容器都处于运行状态。它没有被安装为服务或计划任务,也没有远程部署。这是一个已知并记录在案的限制;迁移到远程执行器首先需要经过认证的网关和容量测量。
“尊重人工智能”是什么意思?
运营意义上的尊重,不是畏惧也不是崇拜:对一个行动快于我们监督能力的系统,在开启之前写好界限,为每项断言提供证据,并由一个人决定唯一不可逆的那一步。这与对任何能访问生产环境的自动化所要求的纪律是一样的。
关于作者和Transgenia
Efraín Carreón Ortiz是墨西哥科技精品公司Centrum Transgenia的首席执行官,承担公司的大部分销售工作。他持有Anthropic颁发的官方Claude Code徽章(Claude Partner Badge),可在Credly上验证。
Transgenia是OpenAI Partner Network中的OpenAI Select Partner,也是Anthropic Claude Partner Network中的Anthropic Registered Partner。团队:Víctor Estrada Bello,Chief PMO;Danild Johan Zambrana López,Chief Technology Officer;Jaime Lozano Castañeda,Chief Marketing Officer;Efraín Carreón Ortiz,Director General(Chief Executive Officer)。
联系我们:contacto@transgenia.org、WhatsApp +52 55 8034 0405、15分钟预约或联系页面。
继续阅读
- 面向墨西哥B2B销售的受治理AI代理:我们如何设计一位SDR:本试点继承的演示动作、硬性规则与半年目标。
- Transgenia如何用受治理的AI智能代理运营企业:我们对任何集成都要求的草稿优先与签核模式。
- 墨西哥谁能把Claude或ChatGPT与Odoo集成?采购指南:对包括Transgenia在内的任何服务商都应书面要求的内容。
- MCP基础设施盘点:本试点之前我们绘制的连接器与权限地图。
- 在Odoo副本上测试AI智能体前应隔离什么:任何写入操作之前的安全测试。
- Transgenia发布MCP-Odoo-Tools:受限连接器所源自的开源MCP服务器。
- AI实施与Odoo集成:服务内容与申请评估的表单。