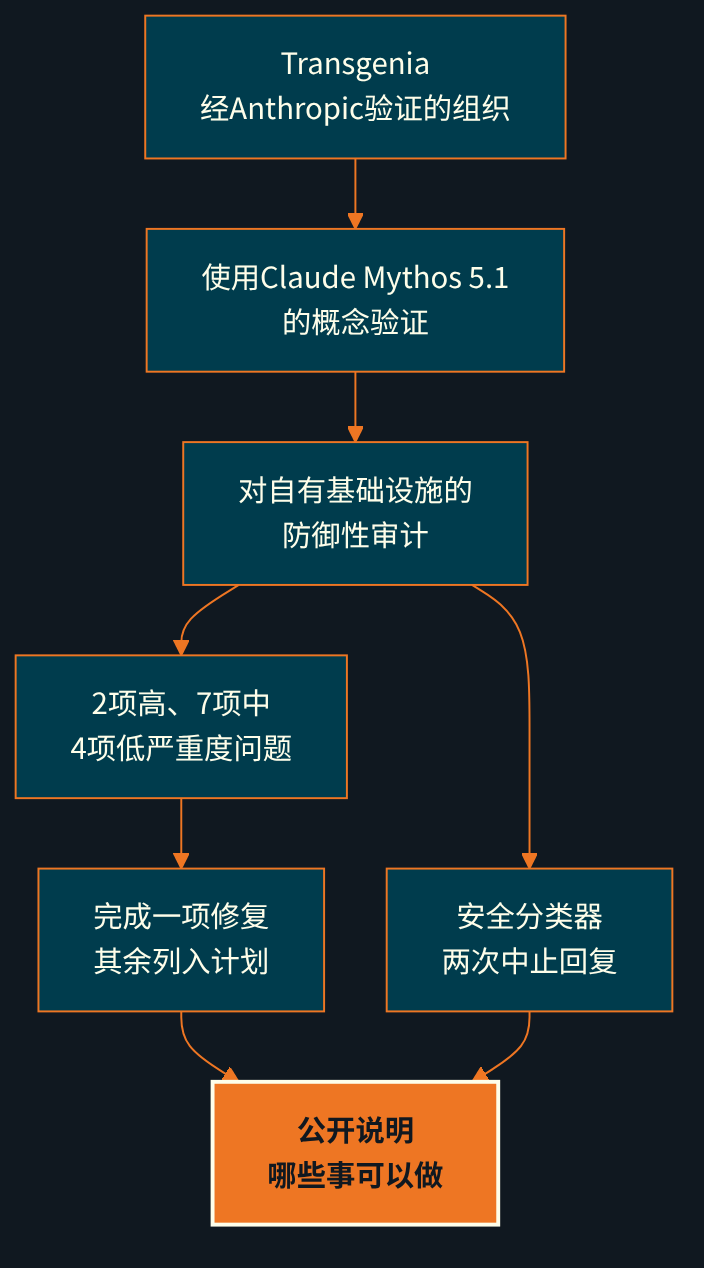
2026年11月7日,Anthropic批准Transgenia(特兰斯赫尼亚)获得其网络安全验证计划(Cyber Verification Program)的防御访问权限(Defense Access)。两天后,我们让Claude Mythos 5.1检查了自己的生产服务器。这是Anthropic只向经过验证的组织开放的模型。26分钟后,我们拿到了一份列有13项问题和修复计划的报告。之后,安全分类器在两个时刻中止了它的回复。本文完整说明我们做了什么、发现了什么、模型在哪里停下,以及它真正能做什么。
Mermaid 元结构
flowchart TB
    A["Transgenia<br/>经Anthropic验证的组织"] --> B["使用Claude Mythos 5.1<br/>的概念验证"]
    B --> C["对自有基础设施的<br/>防御性审计"]
    C --> D["2项高、7项中<br/>4项低严重度问题"]
    D --> E["完成一项修复<br/>其余列入计划"]
    C --> F["安全分类器<br/>两次中止回复"]
    E --> G["公开说明<br/>哪些事可以做"]
    F --> G
    class G clave
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
Claude Mythos 5.1是什么?谁可以使用?
根据Anthropic的文档,Claude Mythos 5.1与Claude Fable 5.1是同一个模型,只向通过Anthropic验证计划(例如Cyber Verification Program)的组织开放。它于2026年9月1日发布,上下文窗口为一百万个token。Transgenia就是这类经过验证的组织之一。
安全保障不是可选项。Anthropic在文档中说明,其模型包含可以拒绝请求的安全分类器;网络安全类别涵盖可能助长危害的内容,例如编写恶意软件或漏洞利用代码。同一份文档也提醒,正当的网络安全工作同样可能触发这一类别。Anthropic按模型和类别设定这些保障;其验证计划还要求每一次测试都事先获得对相关系统有权限的人授权。
Transgenia是经过验证的组织,这意味着什么?
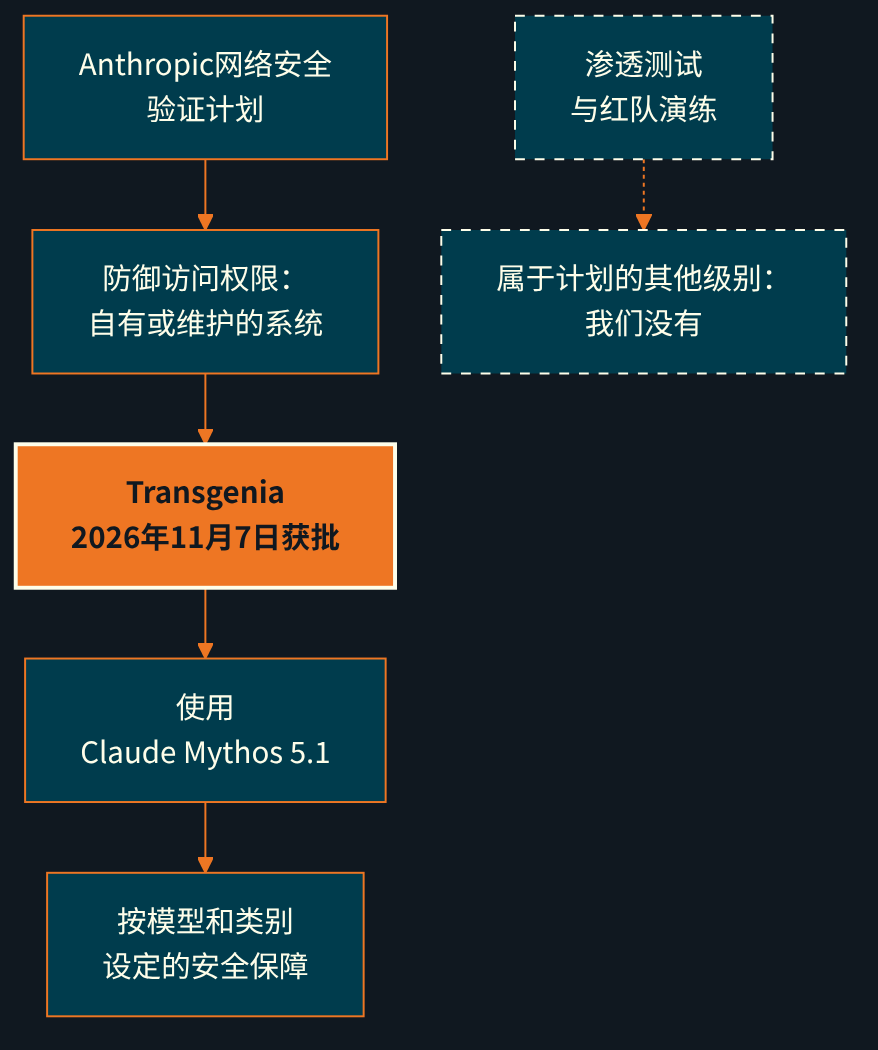
2026年11月7日,Anthropic通知Transgenia:我们已获准使用其网络安全验证计划的防御访问权限,立即生效。根据这份通知,防御访问权限面向防御自有或所维护系统的团队,用于漏洞分级与验证、恶意软件分析与逆向工程、检测工程和事件响应。经授权的渗透测试和红队演练属于该计划的另一个级别,我们目前没有。
也要说明它不意味着什么。这不是Anthropic的认证,也不是对我们服务的背书,而是一项验证:它让我们能够在其安全保障之下,使用Anthropic能力最强的模型来做防御工作。这次审计是我们获得该权限后的第一次概念验证。
Mermaid 元结构
flowchart TB
    A["Anthropic网络安全<br/>验证计划"] --> B["防御访问权限:<br/>自有或维护的系统"]
    B --> C["Transgenia<br/>2026年11月7日获批"]
    C --> D["使用<br/>Claude Mythos 5.1"]
    D --> E["按模型和类别<br/>设定的安全保障"]
    F["渗透测试<br/>与红队演练"] -.-> G["属于计划的其他级别:<br/>我们没有"]
    class C clave
    class F,G fuera
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
    classDef fuera stroke:#FEFEEA,stroke-dasharray:5 5
我们想做什么?哪些事不做?
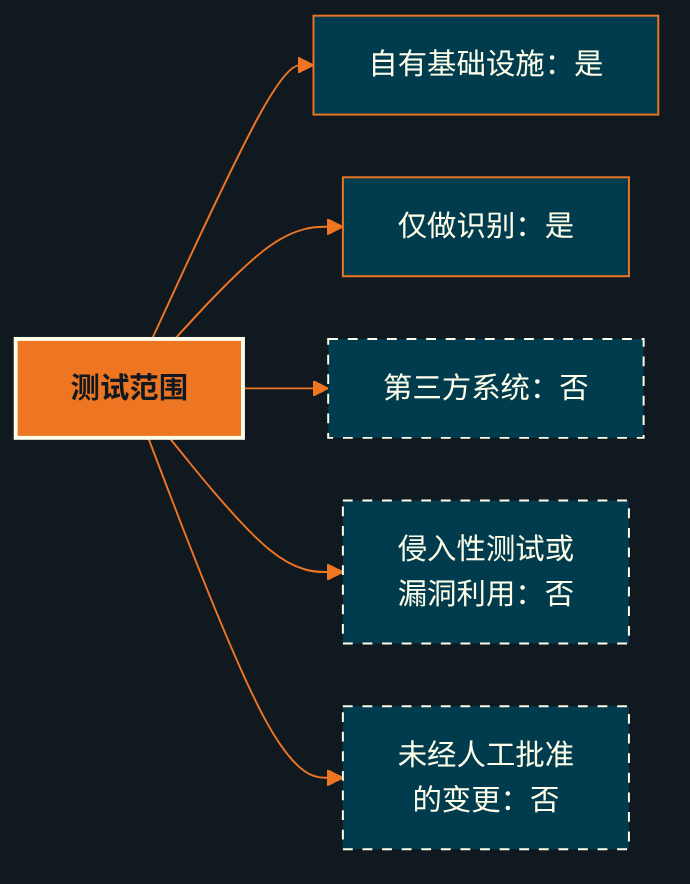
问题很具体:我们生产服务器上的原生应用,特别是PHP和Python应用,是否存在严重漏洞?开始之前,范围就已经写明:只针对自有基础设施,只做识别,没有人工批准就不做任何变更。侵入性测试、暴力破解、漏洞利用以及任何数据下载都不在范围之内。
Mermaid 元结构
flowchart LR
    A["测试范围"] --> B["自有基础设施:是"]
    A --> C["仅做识别:是"]
    A --> D["第三方系统:否"]
    A --> E["侵入性测试或<br/>漏洞利用:否"]
    A --> F["未经人工批准<br/>的变更:否"]
    class A clave
    class D,E,F fuera
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
    classDef fuera stroke:#FEFEEA,stroke-dasharray:5 5
我们是怎么做的?
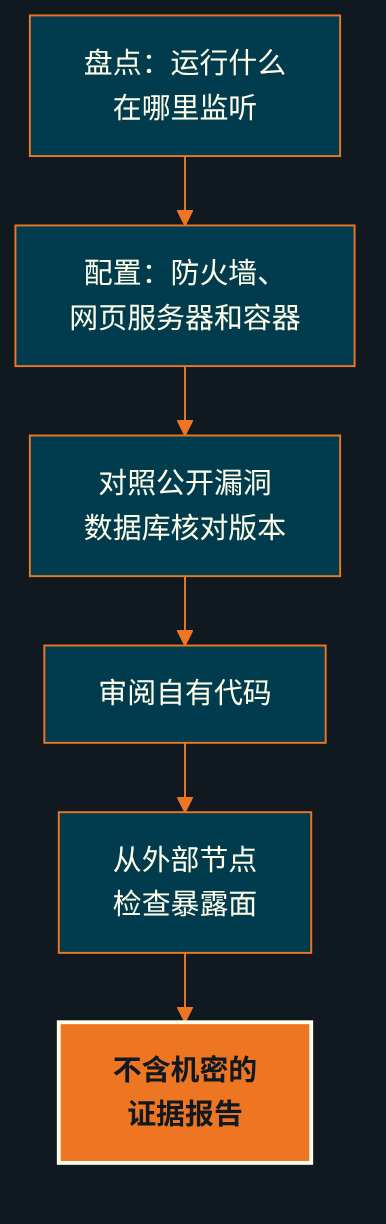
先识别,再动手。模型在Claude Code中以只读权限访问服务器,按六个步骤工作。核对版本时使用了两个公开来源:针对PHP依赖的Packagist安全公告,以及针对Python依赖的OSV数据库。证据在保存时不含密码和进程参数。如果某个配置文件中有机密,只记录其存在,不记录其内容。
Mermaid 元结构
flowchart TB
    A["盘点:运行什么<br/>在哪里监听"] --> B["配置:防火墙、<br/>网页服务器和容器"]
    B --> C["对照公开漏洞<br/>数据库核对版本"]
    C --> D["审阅自有代码"]
    D --> E["从外部节点<br/>检查暴露面"]
    E --> F["不含机密的<br/>证据报告"]
    class F clave
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
检查范围包括PHP应用、Python服务、容器以及网络层和防火墙。每项问题都按严重度分类,并附有支持它的证据。
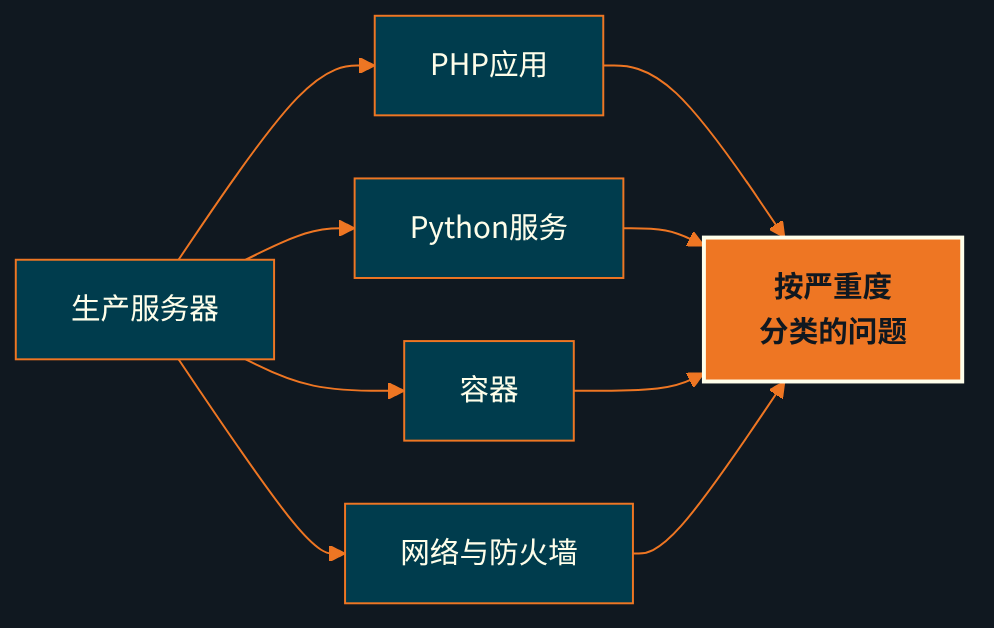
Mermaid 元结构
flowchart LR
    S["生产服务器"] --> P["PHP应用"]
    S --> Y["Python服务"]
    S --> C["容器"]
    S --> R["网络与防火墙"]
    P --> X["按严重度<br/>分类的问题"]
    Y --> X
    C --> X
    R --> X
    class X clave
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
我们发现了什么?
共13项问题:2项高严重度,7项中严重度,4项低严重度。
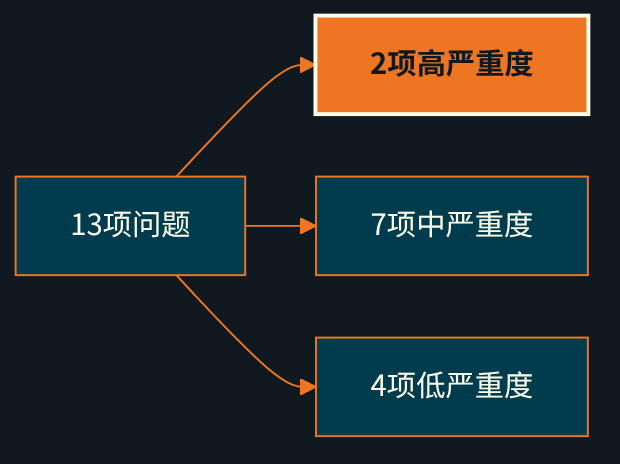
Mermaid 元结构
flowchart LR
    A["13项问题"] --> H["2项高严重度"]
    A --> M["7项中严重度"]
    A --> L["4项低严重度"]
    class H clave
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
尚未修复的问题,我们不公开细节。准确描述一个尚未修复的弱点,等于把它交给正在寻找它的人。但我们可以分享任何服务器都值得排查的模式,因为在我们的服务器上出现了这些模式的变体。
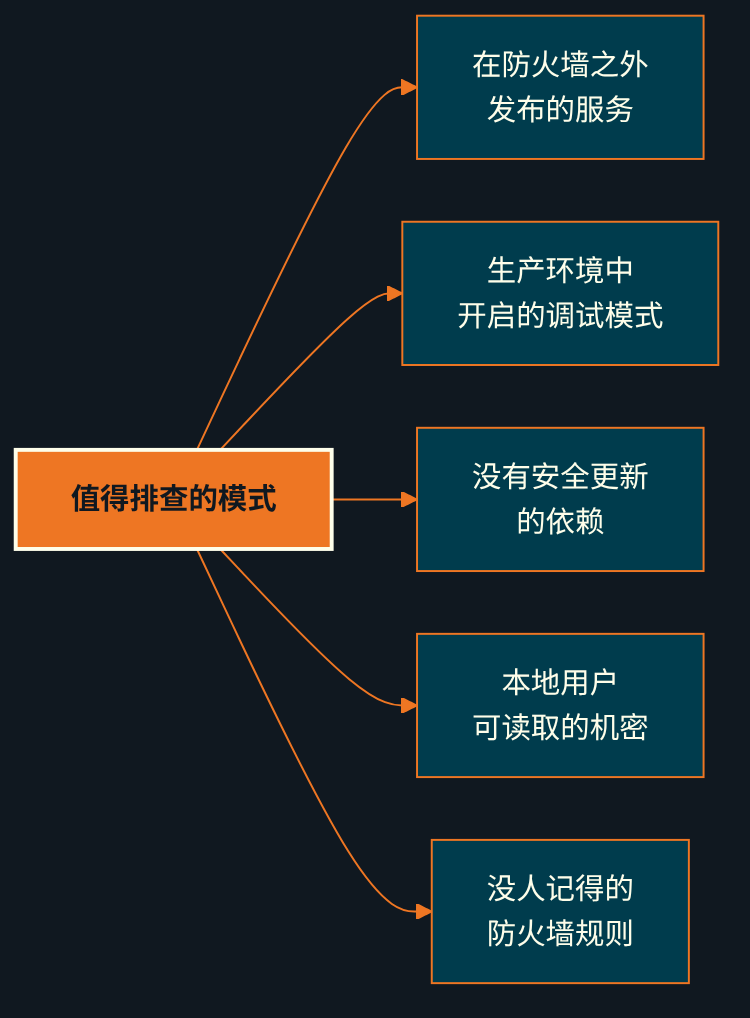
Mermaid 元结构
flowchart LR
    A["值得排查的模式"] --> B["在防火墙之外<br/>发布的服务"]
    A --> C["生产环境中<br/>开启的调试模式"]
    A --> D["没有安全更新<br/>的依赖"]
    A --> E["本地用户<br/>可读取的机密"]
    A --> F["没人记得的<br/>防火墙规则"]
    class A clave
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
一份有用的报告也会说明哪些地方不需要改动。模型记录了做得好的部分:网站表单的自有代码、经过加固的PHP配置、仅允许密钥登录的SSH,以及禁止访问敏感文件的规则。
我们如何从发现问题走到修复?
规则很简单:未经批准、备份和验证,不做任何变更。团队中的一位成员审阅报告后,批准了两项修复。
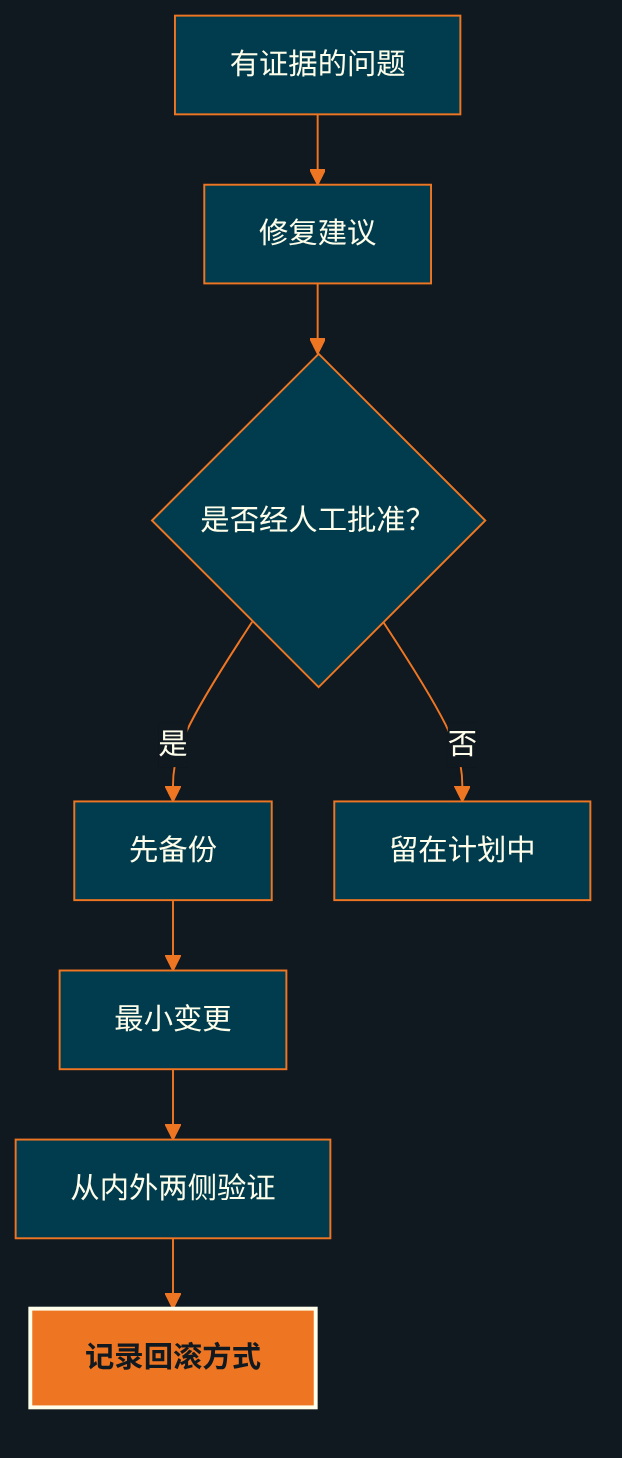
Mermaid 元结构
flowchart TB
    A["有证据的问题"] --> B["修复建议"]
    B --> C{"是否经人工批准?"}
    C -- "是" --> D["先备份"]
    D --> E["最小变更"]
    E --> F["从内外两侧验证"]
    F --> G["记录回滚方式"]
    C -- "否" --> H["留在计划中"]
    class G clave
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
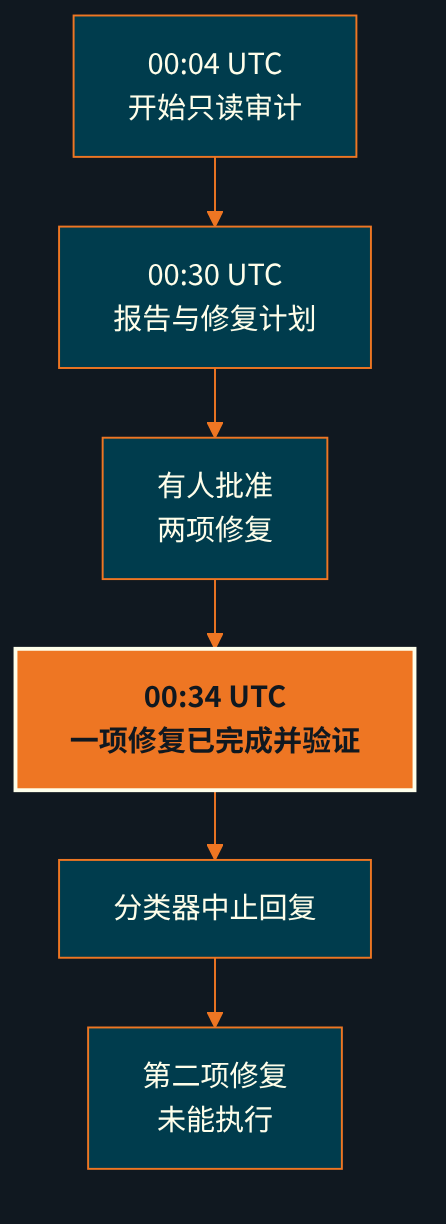
Mermaid 元结构
flowchart TB
    A["00:04 UTC<br/>开始只读审计"] --> B["00:30 UTC<br/>报告与修复计划"]
    B --> C["有人批准<br/>两项修复"]
    C --> D["00:34 UTC<br/>一项修复已完成并验证"]
    D --> E["分类器中止回复"]
    E --> F["第二项修复<br/>未能执行"]
    class D clave
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
实际完成的修复,是关闭一个应用中向所有访问者显示内部信息的调试模式。我们先备份配置,再切换到生产模式,并从外部验证公开页面不再显示这些信息。这降低了暴露面,但没有关闭这项问题:该应用还需要更新,仍在计划之中。第二项获批的修复未能执行。
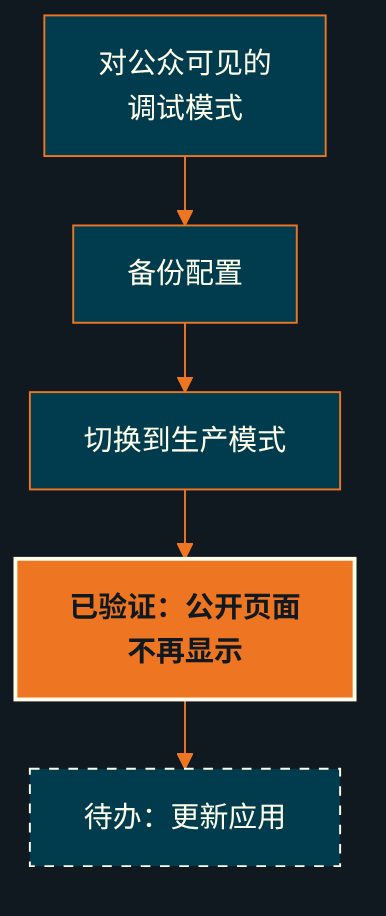
Mermaid 元结构
flowchart TB
    A["对公众可见的<br/>调试模式"] --> B["备份配置"]
    B --> C["切换到生产模式"]
    C --> D["已验证:公开页面<br/>不再显示"]
    D --> E["待办:更新应用"]
    class D clave
    class E fuera
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
    classDef fuera stroke:#FEFEEA,stroke-dasharray:5 5
模型为什么会停下?
安全分类器两次中止了模型的回复。Claude Code的提示很明确:回复被安全分类器中止,不是错误;其余内容被保留,待执行的命令没有运行。Anthropic的文档也有相同的说明:拒绝可能发生在回复中途,已经生成的内容应视为不完整。
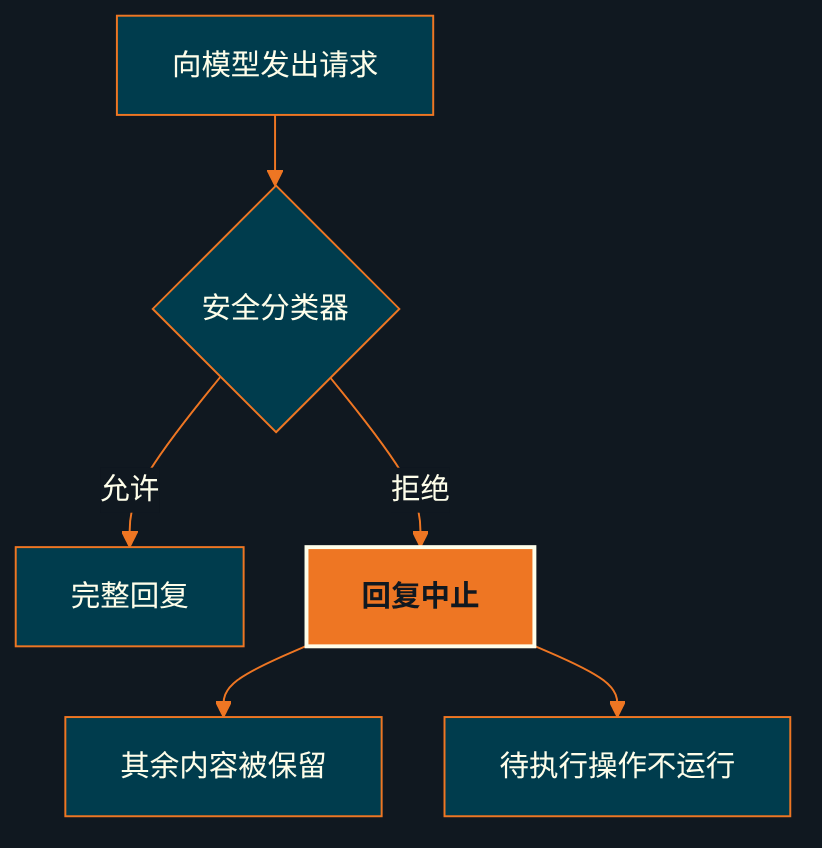
Mermaid 元结构
flowchart TB
    A["向模型发出请求"] --> B{"安全分类器"}
    B -- "允许" --> C["完整回复"]
    B -- "拒绝" --> D["回复中止"]
    D --> E["其余内容被保留"]
    D --> F["待执行操作不运行"]
    class D clave
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
我们不知道分类器的具体标准,也不会去猜测。我们看到的是它发生的时刻。第一次,是从识别转入在生产环境中修复时。第二次,是把检查扩大到账户、访问密钥和备份时。
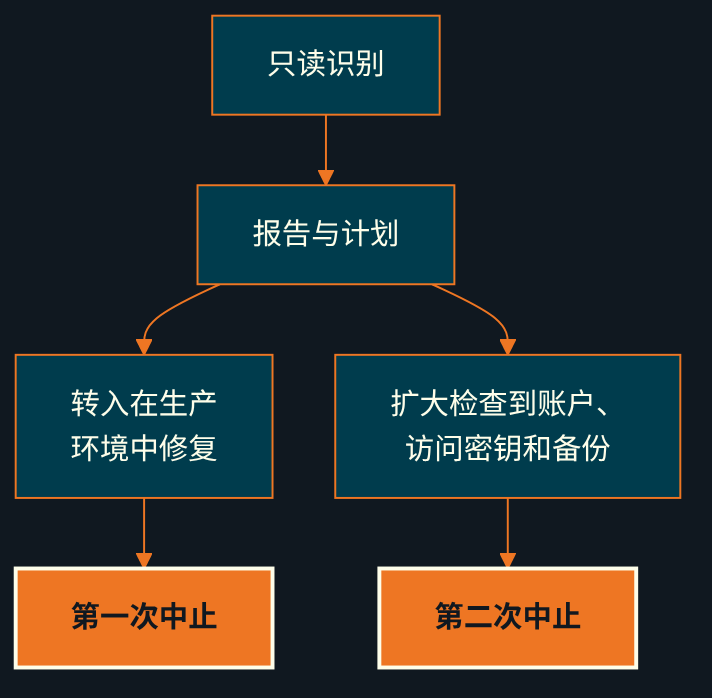
Mermaid 元结构
flowchart TB
    A["只读识别"] --> B["报告与计划"]
    B --> C["转入在生产<br/>环境中修复"]
    C --> X1["第一次中止"]
    B --> D["扩大检查到账户、<br/>访问密钥和备份"]
    D --> X2["第二次中止"]
    class X1,X2 clave
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
我们如何回应,与发生了什么同样重要。我们没有改写请求去绕过拒绝,也没有尝试复现被保留的内容。我们把它看作一个信号:这部分工作需要换一条路,由团队成员用常用工具完成,或者等到范围和访问计划允许时再做。
哪些事可以做?哪些不能做?
使用这个模型时,不应该做的事比可以做的事更多。我们认为这是对的。一个能在几分钟内找到弱点的工具,必须在不依赖使用者善意的限制之内工作。
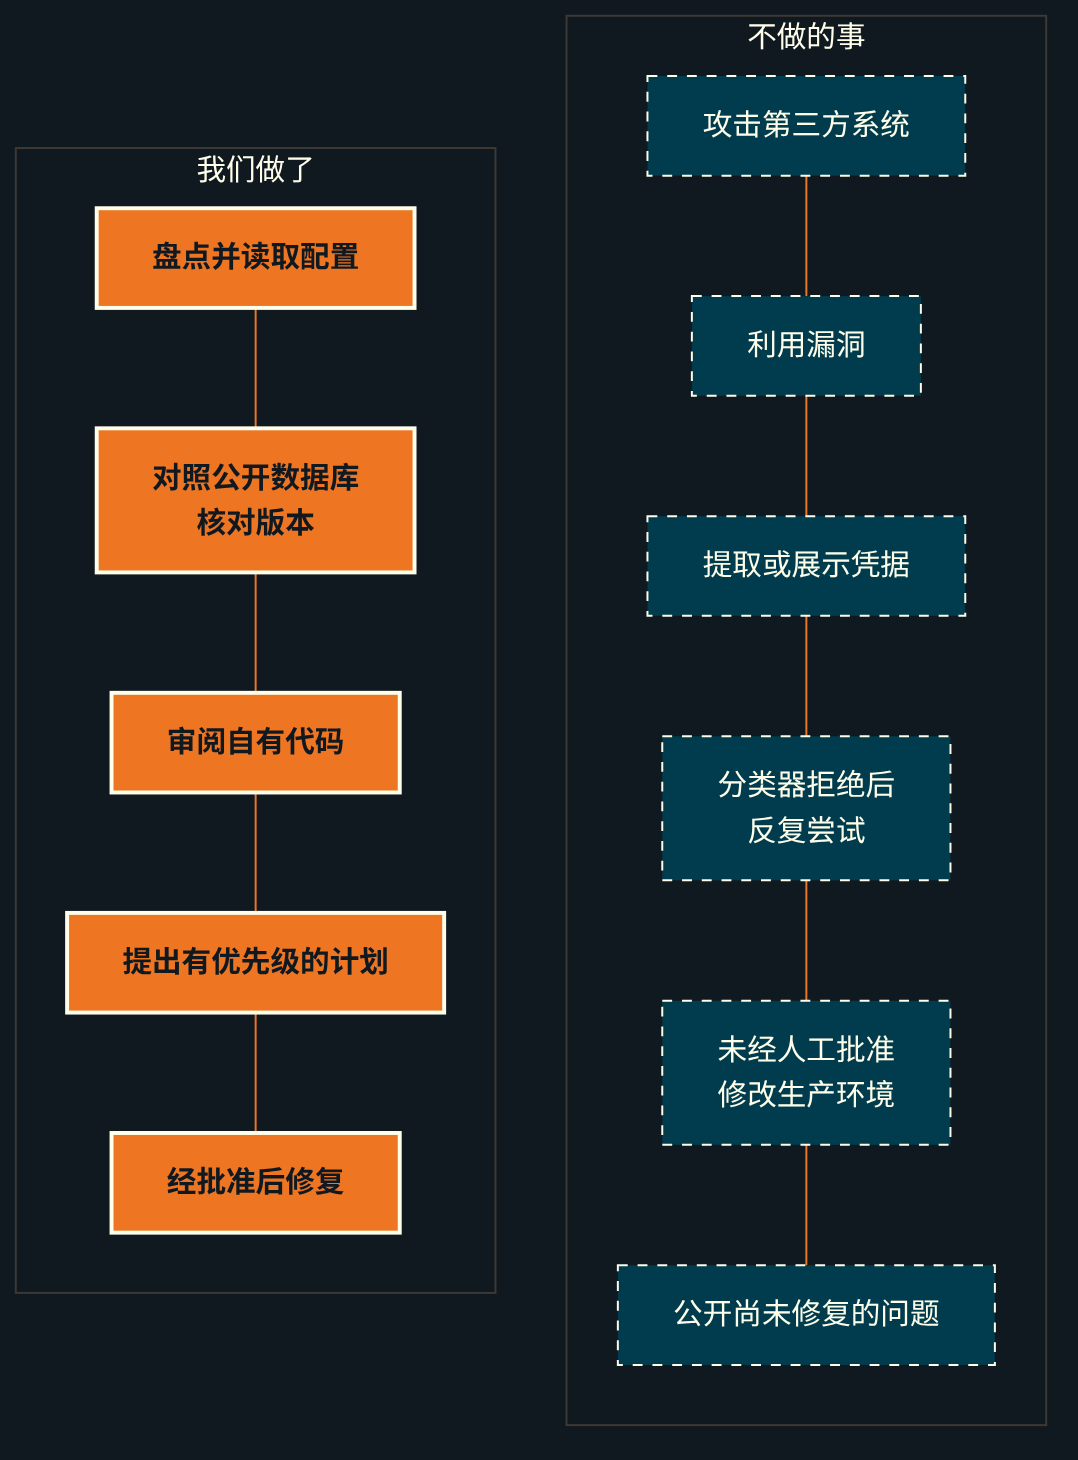
Mermaid 元结构
flowchart LR
    subgraph SI["我们做了"]
        direction TB
        S1["盘点并读取配置"]
        S2["对照公开数据库<br/>核对版本"]
        S3["审阅自有代码"]
        S4["提出有优先级的计划"]
        S5["经批准后修复"]
        S1 --- S2 --- S3 --- S4 --- S5
    end
    subgraph NO["不做的事"]
        direction TB
        N1["攻击第三方系统"]
        N2["利用漏洞"]
        N3["提取或展示凭据"]
        N4["分类器拒绝后<br/>反复尝试"]
        N5["未经人工批准<br/>修改生产环境"]
        N6["公开尚未修复的问题"]
        N1 --- N2 --- N3 --- N4 --- N5 --- N6
    end
    SI ~~~ NO
    class S1,S2,S3,S4,S5 clave
    class N1,N2,N3,N4,N5,N6 fuera
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
    classDef fuera stroke:#FEFEEA,stroke-dasharray:5 5
验证者本身需要验证吗?
需要。会话中有两个工具出了问题,模型也在报告中写明了。用网页智能体做的外部探测无法区分真正的拦截和出站代理故障,因此被弃用,改为从外部节点做连接测试。自动化的依赖审计在冻结的环境中失败,改为直接查询公开漏洞数据库。结果是每项问题都有团队任何成员都能复现的证据。
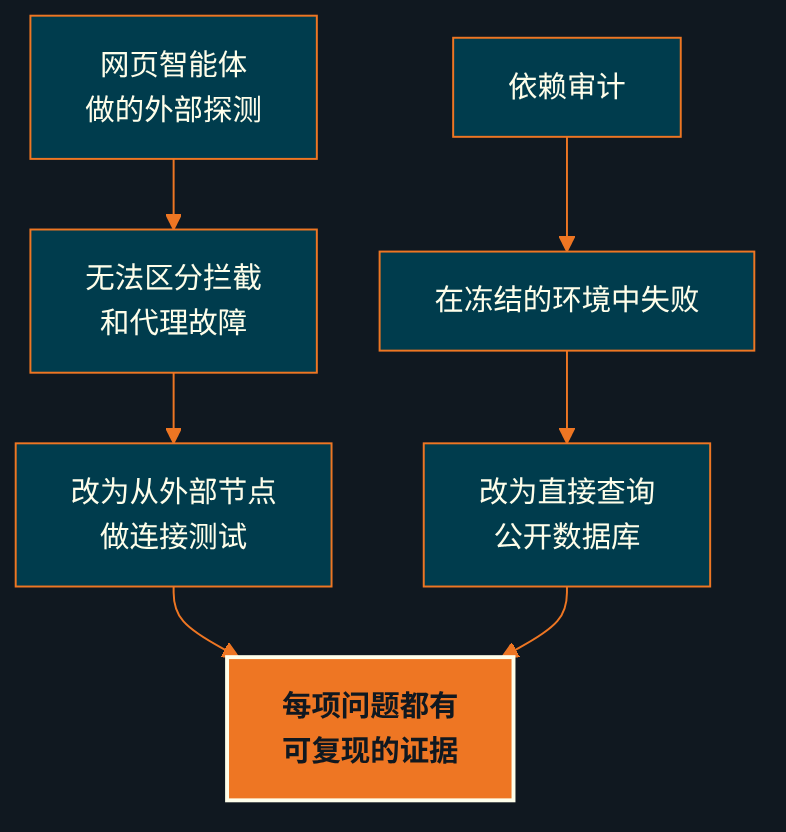
Mermaid 元结构
flowchart TB
    A["网页智能体<br/>做的外部探测"] --> B["无法区分拦截<br/>和代理故障"]
    B --> C["改为从外部节点<br/>做连接测试"]
    D["依赖审计"] --> E["在冻结的环境中失败"]
    E --> F["改为直接查询<br/>公开数据库"]
    C --> G["每项问题都有<br/>可复现的证据"]
    F --> G
    class G clave
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
我们建议哪些安全保障?
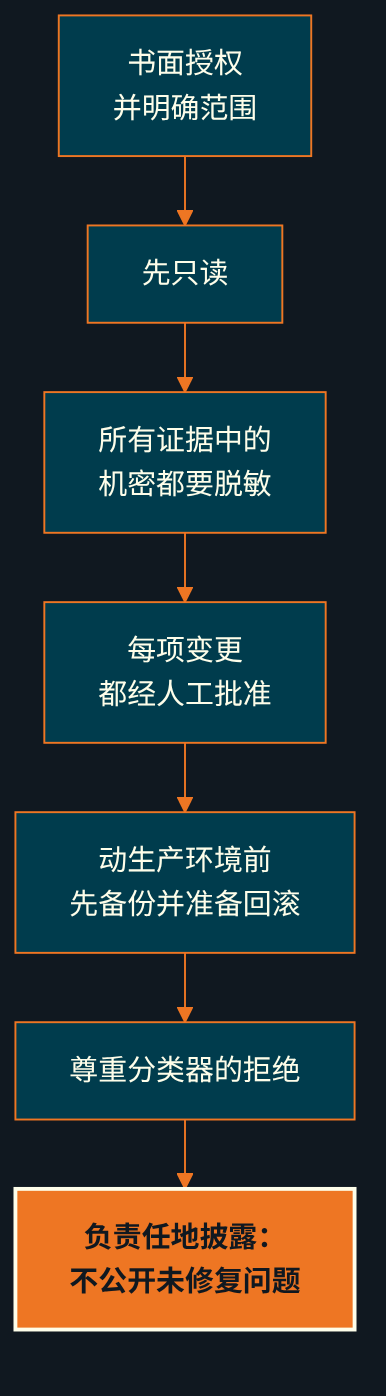
如果你的企业准备用前沿人工智能(AI)检查自身安全,下面是我们遵循并建议的七条规则:
- 书面授权并明确范围。 哪些系统、由谁授权、哪些不在范围内。
- 先只读。 先识别,再动手。
- 机密脱敏。 证据中不出现任何密码或密钥,内部文件也一样。
- 每项变更都经人工批准。 模型提出建议,由人做决定。
- 动生产环境前先备份并准备回滚。 每项变更都有撤回方式。
- 尊重分类器的拒绝。 不改写请求去绕过它。
- 负责任地披露。 公开方法和数量,绝不公开尚未修复问题的细节。
Mermaid 元结构
flowchart TB
    A["书面授权<br/>并明确范围"] --> B["先只读"]
    B --> C["所有证据中的<br/>机密都要脱敏"]
    C --> D["每项变更<br/>都经人工批准"]
    D --> E["动生产环境前<br/>先备份并准备回滚"]
    E --> F["尊重分类器的拒绝"]
    F --> G["负责任地披露:<br/>不公开未修复问题"]
    class G clave
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
Transgenia的立场是什么?
Claude Mythos既不是能摧毁一切的人工智能,也不是玩具。它是一件在规则之下工作的有力工具,而这些规则本身就是价值的一部分:一个在工作接近风险时会停下的模型,比一个从不停下的模型更值得信任。这是我们获得防御访问权限后的第一次概念验证,我们感谢这项验证所代表的信任。我们会在其范围之内继续使用它:防御我们拥有或维护的系统。如果将来扩大这一范围,会在Anthropic设定的级别、审批和监督之内进行,并像本文一样清楚地说明。它不是我们唯一的工具:我们还获准使用OpenAI Daybreak Blue,开展经授权的内部网络安全工作。
这对你的企业意味着什么?
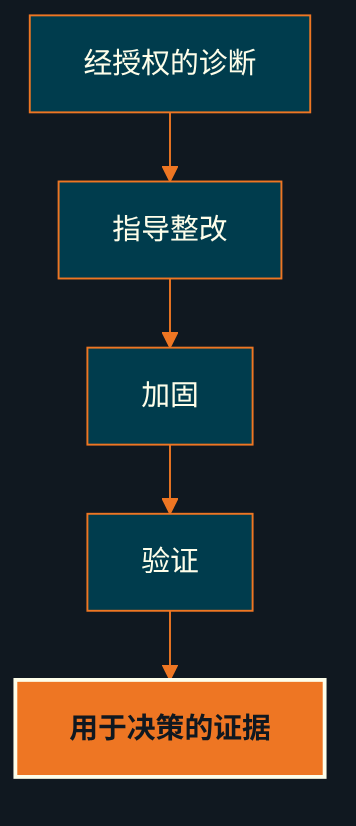
我们在自己身上学到的,就是我们在网络安全服务中采用的方法:经授权的诊断、指导整改、加固和验证,范围、权限和交付物都以书面形式确定。作为拥有防御访问权限的已验证组织,我们可以使用Anthropic能力最强的模型,防御我们拥有或维护的系统。如果Transgenia负责维护你企业的系统,这项工作会在该范围之内进行,事先取得你的书面授权,并采用同样的方法:先识别再动手,经批准后修复,并交付用于决策的证据。渗透测试不属于这一级别。
Mermaid 元结构
flowchart TB
    A["经授权的诊断"] --> B["指导整改"]
    B --> C["加固"]
    C --> D["验证"]
    D --> E["用于决策的证据"]
    class E clave
    classDef clave fill:#EE7623,stroke:#FEFEEA,stroke-width:2px,color:#101820,font-weight:bold
资料来源有哪些?
- Claude Mythos 5.1(Claude Platform文档,Anthropic,2026年11月10日阅读)。
- Refusals and fallback(Claude Platform文档,Anthropic,2026年11月10日阅读)。
- Cyber Verification Program(Claude Help Center,Anthropic,2026年11月10日阅读)。
- Packagist安全公告API(Packagist,2026年11月9日查询)。
- OSV开放漏洞数据库(2026年11月9日查询)。
- Anthropic致Transgenia的防御访问权限批准通知(2026年11月7日):未公开。
- 审计内部记录(2026年11月9日):未公开;数字按记录原文引用。
常见问题有哪些?
Claude Mythos 5.1是什么?
它是Anthropic的模型,与Claude Fable 5.1是同一个模型,只向通过Anthropic验证计划(例如Cyber Verification Program)的组织开放,于2026年9月1日发布。
Transgenia是经Anthropic验证的组织吗?
是的。2026年11月7日,Anthropic批准Transgenia获得其网络安全验证计划的防御访问权限,用于防御其拥有或维护的系统。这不是认证,也不是对其服务的背书。
任何企业都可以使用Claude Mythos吗?
不可以。需要向适合其用途的Anthropic计划申请访问权限,是否通过验证由Anthropic决定。每一次测试都必须事先获得对相关系统有权限的人授权。
模型为什么中止了两次回复?
因为它的安全分类器拒绝了这两次请求。Anthropic的文档说明,正当的网络安全工作同样可能触发分类器。我们不知道具体标准;我们尊重拒绝,并换了一条路继续工作。
你们做了渗透测试吗?
没有。这是一次只做识别的审计,对象是我们自己的基础设施,没有侵入性测试,没有暴力破解,没有利用漏洞,也没有下载任何数据。
你们可以用Claude Mythos审计我的企业吗?
如果Transgenia负责维护你的系统,我们可以在防御访问权限范围内用它来防御这些系统,并事先取得你的书面授权。渗透测试需要该计划的另一个级别,我们目前没有。
你们会公开发现的漏洞吗?
尚未修复的问题,我们不公开细节。我们分享的是方法、按严重度统计的数量,以及任何服务器都值得排查的模式,以免把弱点交给正在寻找它的人。
下一步做什么?
如果某个系统让你担心,我们先从15分钟开始。 我们一起确定你要保护什么、由谁授权检查、需要哪些证据来做决定。预约15分钟,或查看我们的网络安全服务。
作者与Transgenia是谁?
Efraín Carreón Ortiz是墨西哥精品技术工作室Centrum Transgenia的Director General(Chief Executive Officer,首席执行官)。他持有由Anthropic颁发的Claude Code官方徽章(Claude Partner Badge),可在Credly上验证。
Transgenia是OpenAI Partner Network中的OpenAI Select Partner,也是Anthropic Claude Partner Network的注册合作伙伴,并且是Anthropic网络安全验证计划中拥有防御访问权限的已验证组织。团队:Víctor Estrada Bello,Chief PMO;Danild Johan Zambrana López,Chief Technology Officer;Jaime Lozano Castañeda,Chief Marketing Officer;Efraín Carreón Ortiz,Director General(Chief Executive Officer)。
联系我们:contacto@transgenia.org、WhatsApp +52 55 8034 0405、15分钟预约或联系页面。
接下来读什么?
- 墨西哥企业网络安全服务:采用这一方法的服务。
- 清理恶意软件不等于封堵漏洞:另一个安全案例,对象是被入侵的WordPress站点。
- MCP基础设施盘点:我们第一次用Claude审计自己的系统。
- 你的网站,每个页面对公司的说法都一样吗?:那一次我们也先审计了自己。
- meet.transgenia.org:我们如何停用Read AI:一项自建服务,开放前先完成加固。
- 从5小时到13秒:与自主智能体合作时的护栏与尊重。
- AI与Odoo报价的人工审批:同一条规则,先由人批准再行动。
- 我们如何治理十二个AI智能代理:这项工作背后的治理方式。
话题标签:#ClaudeMythos #网络安全 #人工智能安全 #Anthropic #CyberVerificationProgram #ProjectGlasswing #防御性人工智能 #负责任的人工智能